返回 TraceWise 项目总览 · 交互图:核心 · 知识 · 副本 · 工作流 / 证据 · 数据 · 血缘
一个项目快照显示 compatible=true,用户点击导入,系统也返回成功。这个结果能不能叫“备份恢复完成”?
不能。
在一个以 Graph、Evidence、规则和历史运行为核心的产品里,“文件能解析”“几个对象写进数据库”和“项目已经恢复”是三件完全不同的事。快照可能包含当前导入器不认识的新分区;Relation 可能指向不存在的 Entity;Evidence 可能引用错误 Graph;预览之后文件还可能被替换;写入到一半也可能失败。更关键的是,即使核心知识都复制成功,SimulationRun、Agent interaction、报告、活动和 timeline 仍可能没有被恢复。
如果产品把这些情况都压成一个绿色的 compatible 或 success,它制造的不是便利,而是一份可信度很高的假象。
TraceWise 因而没有继续把这条能力叫“项目恢复”,而是把它收敛为一个更窄、更可验证的合同:**从受支持的项目快照中创建一个隔离的核心知识副本。**它只复制 Entity、Relation、Evidence 和 Rule;先展示复制与省略分区;预检任何未知结构和悬空引用;把确认动作绑定到用户实际审阅的文件指纹;写入新 Draft 项目并重映射 authority IDs;最后保存 Applied 或 Partial receipt。
这篇文章只回答一个问题:怎样让一次受限快照复制既可用、可重试、可审计,又不被误解为完整备份、生产迁移或灾难恢复?
当前正式产品版本是 tracewise-product==0.2.0a12。本文讨论的核心知识副本来自这条正式版本线中已经形成结构化验收、并在当前状态文档中继续保留的能力切片。它证明的是本地受控复制合同,不证明生产数据迁移、跨区域恢复或模型质量。
真实产品截图:项目知识结构在 Graph 画布中被实际渲染。数据为合成示例;截图不证明复制或恢复,后者必须由后端合同与执行证据证明。
起点不是“怎么导入”,而是“用户以为恢复了什么”
快照功能最容易从文件解析器出发:读 JSON,检查 schema,循环插入,然后返回 201。这样很快能做出一个按钮,但它回避了用户真正关心的问题:新项目里到底有什么,缺了什么,原项目是否变化,重复点击会怎样,写到一半失败后又会怎样。
项目快照还有一种特别危险的 false-green:导出端保存了很多分区,导入端只支持其中一部分,却仍然返回 compatible。文件结构看起来正确,用户也看到“导入成功”,但运行历史、报告或活动没有进入新项目。只要界面没有明确展示省略项,用户自然会把“部分复制”理解成“完整恢复”。
因此,TraceWise 把第一个不变量写在能力名称里:
只有合同明确支持的核心知识可以被称为已复制;任何未恢复内容都必须在确认前可见,不能被 success 状态吞掉。
验收也随之分为四项:受支持分区是否完整复制,省略分区是否列明,错误输入是否被拒绝,以及部分失败是否留下结果记录。
先定义复制合同,再讨论实现
当前快照 schema 是 tracewise.project_snapshot.v1。复制合同将内容分为两组。
会进入新项目的核心知识:
- Entity / nodes:项目中的知识实体;
- Relation / links:实体之间的关系;
- Evidence:支撑实体和关系的证据;
- Rule:用于推理或判断的产品规则。
不会由这条能力恢复的运行态与历史:
- Graph changes;
- document tasks;
- activity;
- report drafts;
- Simulation runs;
- Agent interactions;
- timeline。
为什么不把这些内容顺手一起复制?因为它们不是几个独立 JSON 数组。一次 SimulationRun 可能绑定输入、timeline、输出、完整性指纹和衍生 Evidence;一次 Agent interaction 可能依赖当时的上下文、模型配置和调用结果;报告可能引用特定 run、Evidence 或实体版本。若只复制表面记录而不复制其 authority、依赖和完整性合同,新项目得到的会是一组看似完整、实际不可验证的历史。
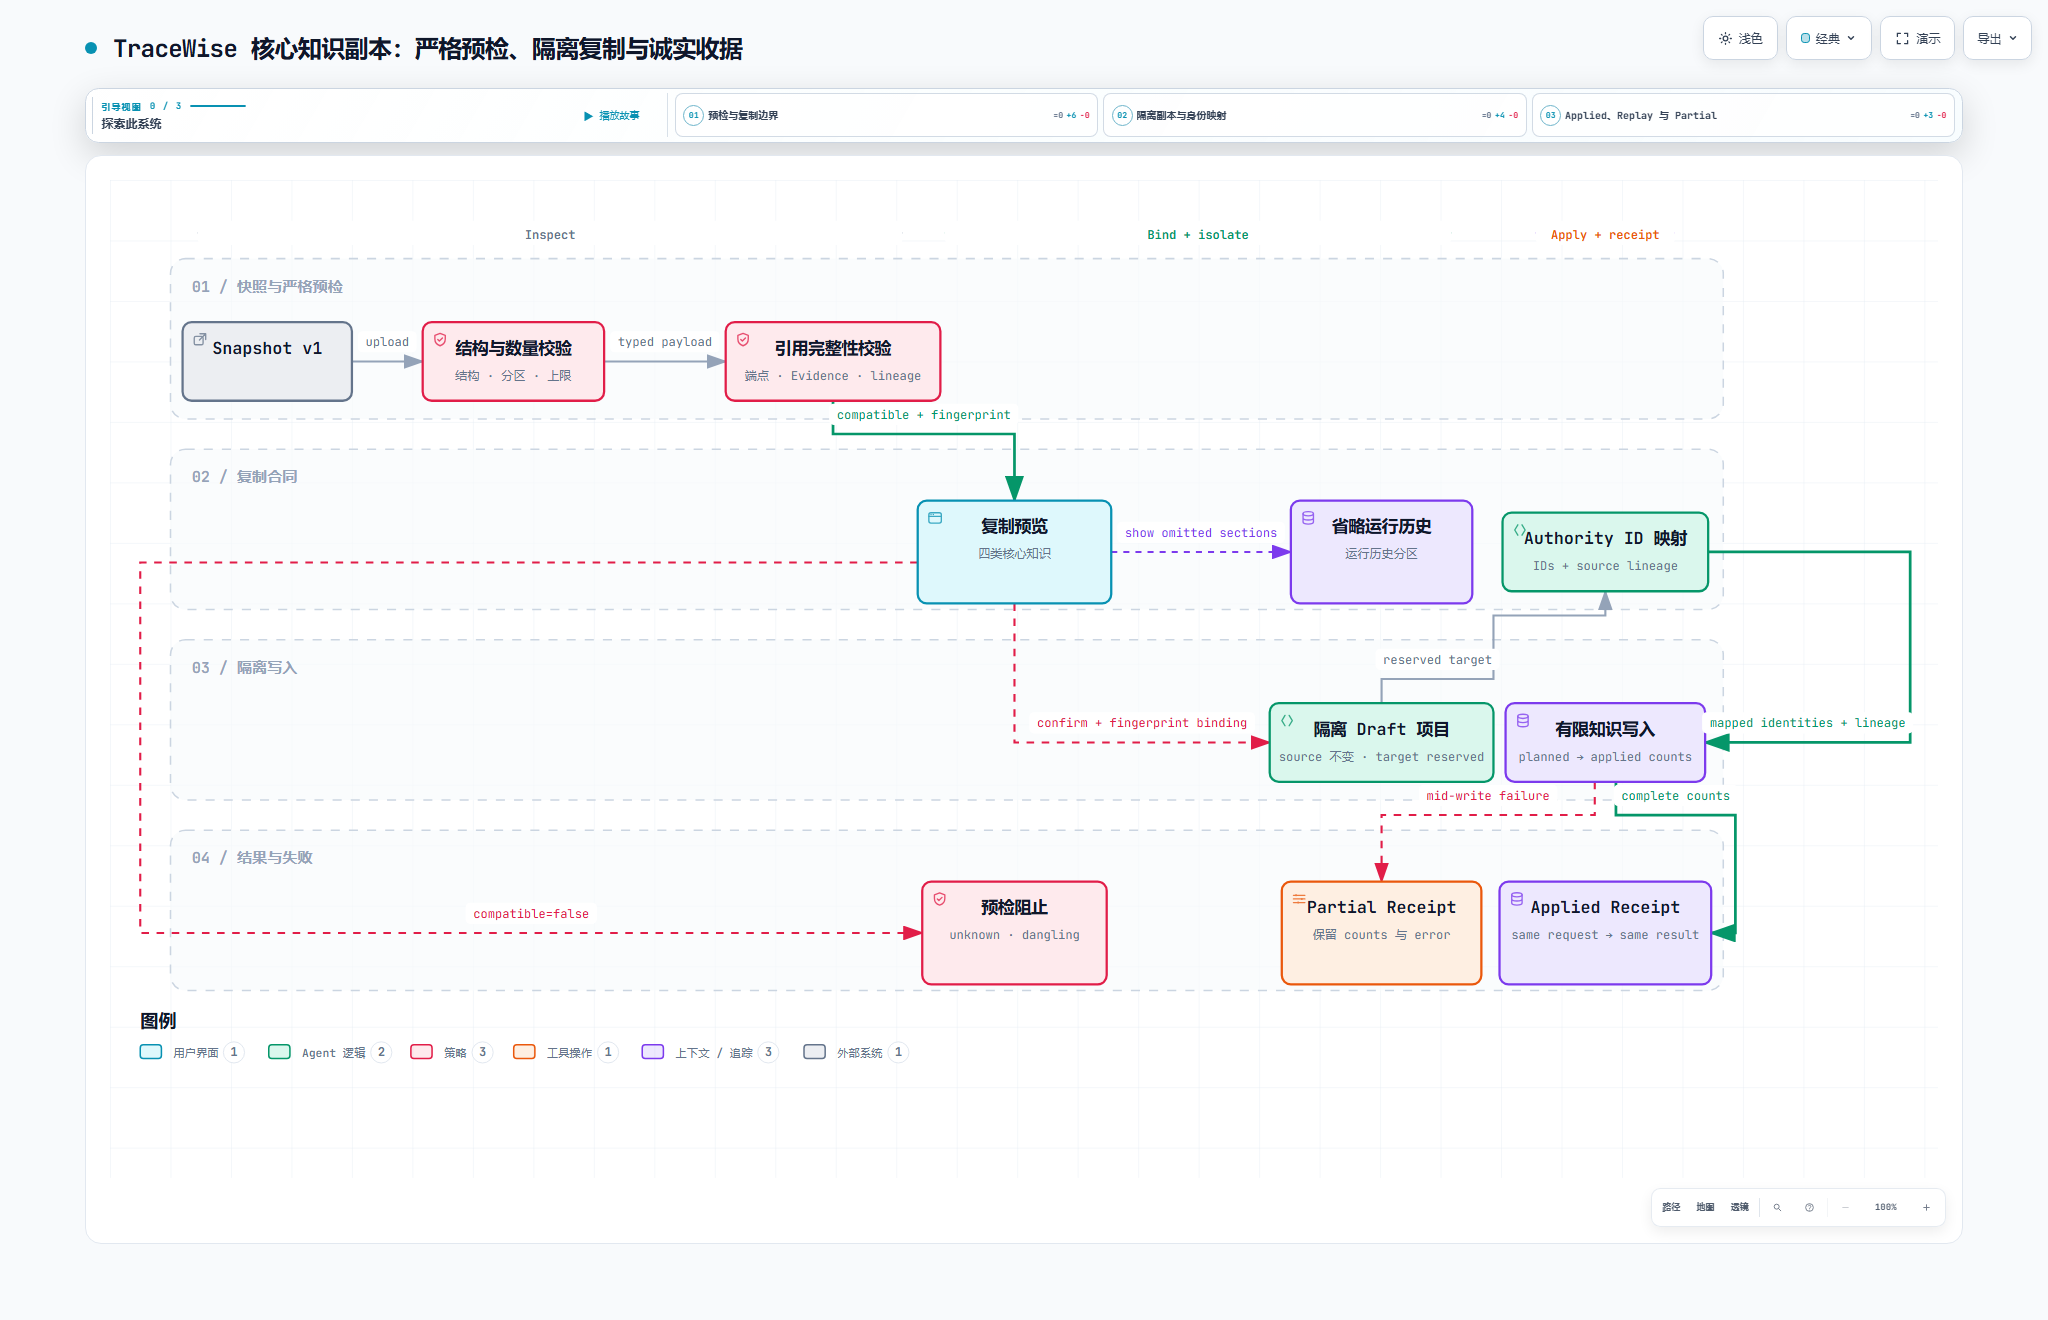
技术解释图:Snapshot 先经过结构、数量和引用完整性校验;预览明确显示复制与省略分区;确认绑定 fingerprint 后才创建隔离 Draft,并产生 Applied 或 Partial receipt。
compatible=true 必须代表什么
在这条路径里,compatible 不是“JSON.parse 没报错”。预检至少要回答四层问题。
第一层:结构和身份
输入必须符合快照 schema,并且 project、graph、operations、timeline 等顶层结构处于当前合同范围内。项目身份与 Graph 身份要互相一致,typed payload 必须能被当前模型解析。
第二层:规模边界
即使结构正确,也不能让任意大小的文件直接进入内存和写入路径。当前合同为 nodes、links、Evidence 和 rules 设置明确数量上限。上限不是性能优化备注,而是输入可信边界的一部分。
第三层:Graph 完整性
Entity ID、Relation ID 和其他 authority ID 不能重复;每条 Relation 的 source 与 target 必须存在;同一关系不能靠重复记录制造歧义。Graph 的“边”只有在两个端点都有效时才有意义。
第四层:引用完整性
Evidence、Rule 和 Relation 内部的引用必须落在当前 Graph 的合法对象上。Evidence lineage、Relation evidence refs、Rule entity refs 都需要校验。一个 Evidence 对象本身字段齐全,不代表它引用的实体真实存在。
这些检查决定了预检是“复制计划生成器”,而不是上传后的格式提示。预览返回 restored counts、omitted counts、warnings 和 blockers;只有 blockers 为空时,用户才可以进入确认。
未知分区为什么必须失败关闭
兼容性处理中常见的做法是忽略未知字段。这对普通展示配置可能合理,对恢复类操作却非常危险。
假设后续导出器新增 unexpected_runtime_state,其中保存一类会影响项目行为的新权威数据。旧导入器如果静默忽略它,仍然可以复制四类已知数据并返回 success。但用户并不知道新项目缺少这块状态,系统也没有证据证明忽略它是安全的。
TraceWise 的负例验收要求:出现未知顶层分区时,preview 必须 compatible=false,界面展示 blocker,确认按钮不可用。这里宁可拒绝一个未来版本的文件,也不把“我不认识”翻译成“它不重要”。
同样的原则适用于悬空关系端点和丢失的 Evidence 引用:不能删除坏边后继续,也不能自动补一个空实体。恢复路径的职责不是猜测作者意图,而是证明输入满足当前复制合同。
预览与确认之间还存在一次竞态
即使预检完整,仍有一个容易被忽略的窗口:用户看到的是文件 A 的预览,点击确认时,磁盘上的内容已经变成文件 B。
如果 import 只复用文件路径,它执行的可能不是用户确认的内容。界面展示的 counts、warnings 和 omitted sections 都会失去约束力。
解决方式不是在按钮上再写一句“请勿修改文件”,而是让 preview 计算稳定 fingerprint,并要求 import 携带 expected_fingerprint。执行前重新读取并计算;只要字节或规范化内容发生变化,就返回 snapshot_copy_fingerprint_mismatch,不创建目标项目。
这建立了第二个不变量:
确认动作只能授权用户刚刚审阅过的那份快照,不能授权同一路径下未来出现的任意内容。
需要说明的是,fingerprint 只证明“预览和执行针对相同内容”,不证明文件来源可信。数字签名、制品来源认证和供应链安全仍是更高一层的合同。
隔离复制:新身份,不覆盖原项目
预检通过后,系统不会把内容直接写回源项目。它创建新的 project ID 和 graph ID,将目标状态设为 Draft,并在标题中标明知识副本。验收同时检查源项目在复制后保持不变,源与副本可以在界面中同时看到。
隔离有三个直接价值。
第一,用户可以检查副本,而不让一次导入操作污染原项目。第二,任何后续人工修订都有明确目标,不会把“恢复动作”和“编辑原项目”混在一起。第三,写入失败时,Partial 状态可以被限定在新目标中,而不是让源项目进入未知状态。
但“隔离项目”不能被扩大成“安全租户”。graph_id 和 project ID 提供的是产品逻辑分区;生产环境仍然需要可信身份、tenant/RBAC、资源所有权、水平越权测试和基础设施隔离。
为什么所有 authority ID 都要重映射
如果副本保留源项目的 Entity、Relation、Evidence 和 Rule IDs,两套项目就会声称拥有同一批权威对象。后续编辑、引用和审计很难判断一个 ID 指向源对象还是副本对象;跨 Graph 查询也可能把两个世界错误合并。
因此复制路径为四类对象生成新 IDs,同时维护 source-to-target identity mapping:
- Relation 的端点改为副本 Entity IDs;
- Evidence 的实体引用改为副本身份;
- Rule 的实体引用同样映射;
- Relation 保留 snapshot-copy source lineage,说明它从哪个源关系复制而来。
这看似只是 ID 转换,实际是在维护两个互相补充的事实:新项目拥有独立 authority;新对象仍能解释自己的来源。只保留新 ID 会丢失血缘,只保留旧 ID 又会破坏隔离。
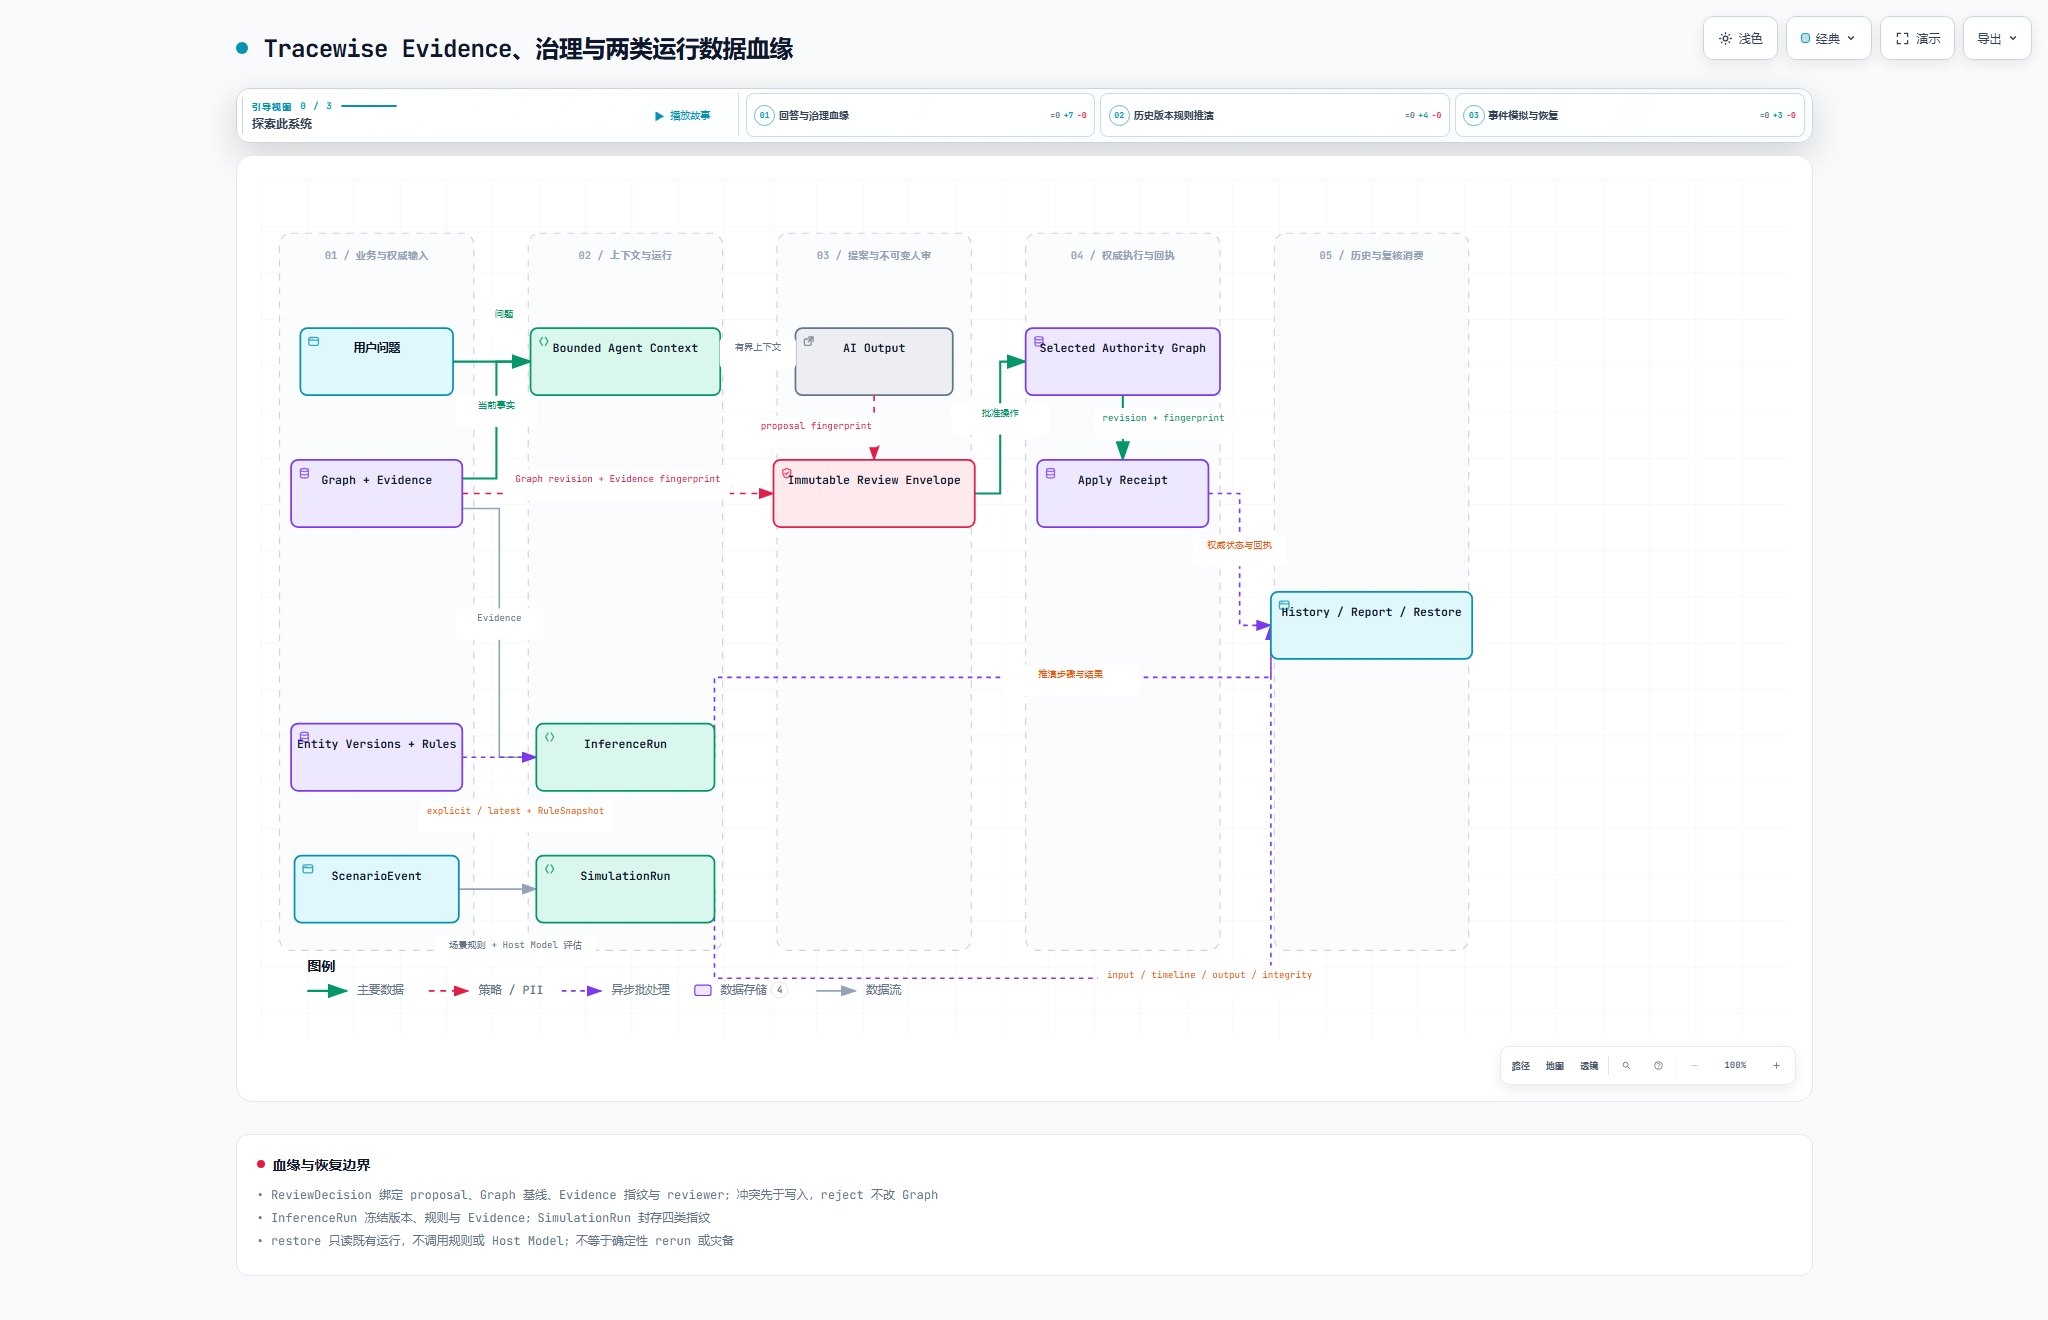
技术解释图:Entity Versions、Rules、Evidence 与 InferenceRun、SimulationRun、History/Report 有不同依赖链。核心知识副本只复制前者,不伪造后者的恢复。
幂等不是“请求成功两次”,而是“同一意图只有一个结果”
上传操作经常遇到超时:服务可能已经写完,客户端却没收到响应。用户重试时,系统需要判断这是不是同一个复制意图。
TraceWise 要求 import 携带 UUID 形式的 import_request_id,并从它确定目标身份。第一次执行会保存 receipt;相同 request 与相同 fingerprint 的精确 replay 返回同一份 immutable receipt,不再次创建项目,也不重复写 Entity、Relation、Evidence 或 Rule。
如果同一个 request 被拿来提交不同 fingerprint,系统会拒绝,因为它已经不再是同一意图。如果确定性目标已经被其他状态占用,也会失败关闭,而不是悄悄换一个随机目标继续。
这里可以严谨地说“受控单机合同中的精确 replay 不重复写入”。不能说分布式 exactly-once:多进程竞态、跨数据库事务、网络分区和生产级协调并未由这项验收覆盖。
receipt 为什么比一条 success toast 更重要
复制不是单个 insert。系统需要创建项目,再写 nodes、links、Evidence 和 rules。一次结果至少要记录:
- import request identity;
- source 与 target identity;
- snapshot fingerprint;
- planned counts;
- applied counts;
- omitted counts;
- identity mapping;
- warnings;
- terminal status;
- error(如果存在)。
Applied receipt 证明的是:在这次受控执行中,四类 planned counts 与 applied counts 一致。它不是完整项目备份证明,因为 omitted counts 本来就不为零。
receipt 还承担重放语义。精确 replay 返回同一终态,而不是重新跑一遍并生成一份“差不多相同”的记录。这样,客户端可以在超时后安全查询或重试,同时保留原执行事实。
最难的决定:中途失败时承认 Partial
理想情况下,所有写入都位于一个强事务中,要么全部提交,要么全部回滚。但当前产品路径并没有足够证据支持把跨对象、潜在跨 authority 的操作描述为原子事务。
如果在 nodes 已写入后,relation 写入被注入失败,最糟糕的做法有两种:一是返回 generic error 却不说明已写入什么;二是声称“已回滚”,但目标项目和 nodes 实际仍然存在。
TraceWise 保存 terminal partial receipt,记录当时的 applied counts 与 error。负例中,目标 Draft 和 2 个 nodes 被保留,links、Evidence、rules 的 applied counts 为 0。再次用相同 request replay,不会继续补写或复制第二份,而是返回同一 Partial receipt。
这不是对 Partial 的赞美。它明确暴露了当前缺少自动补偿与事务性清理,也让运维或后续产品流程知道目标处于什么状态。比起“看起来原子”,可审计的不完整结果更安全。
UI 不是给后端合同贴一层皮
后端的 restored/omitted/blockers/warnings 如果没有进入用户决策界面,仍然可能被误用。
核心知识副本对话框因此把关键信息放在确认前:
- 标题直接写“创建核心知识副本”;
- 说明原项目不会变化,新项目是 Draft;
- loading 阶段明确检查结构、Graph endpoints、Evidence refs 和 partitions;
- compatible 与 blocked 使用不同 verdict;
- 分别列出“会复制到新项目”和“不会恢复的运行历史”;
- blocker 存在时禁用确认按钮;
- 边界文案明确说它不是完整备份、生产迁移或灾难恢复。
浏览器验收不仅检查 success。它还构造未知分区,确认 blocker 可见且主操作 disabled;检查源项目与副本同时出现;覆盖 1440、768、414、375 和 320 宽度,没有横向溢出,并保留约 44px 的主操作触控目标。
这类 UI 工作没有增加后端数据完整性,但它降低了用户把受限能力理解成完整恢复的风险。对治理型功能来说,这本身就是产品价值。
一次受控验收具体证明了什么
结构化 acceptance 使用的源项目为 model-post-training,Graph 为 demo。预检识别出:
- 48 个 nodes;
- 77 个 links;
- 2 条 Evidence;
- 2 条 rules;
- 4 条 timeline,明确省略。
执行后,四类 applied counts 与 planned counts 完全一致;目标是新的 Draft 项目;源项目保持不变;Relation lineage 被核验;receipt 持久化进 SQLite。exact replay 返回同一 receipt,没有重复数据。
负例覆盖未知顶层分区、悬空 relation endpoint、预览后 fingerprint 漂移、确定性目标被占用和中途 relation 写入失败。形成该切片时,focused backend 为 6 passed,完整 backend 为 113 passed;frontend 为 22 files / 65 tests,另有独立 tsc、eslint、build、ruff 和 diff gate。
这些数字证明一条受控本地路径和它的关键反例。它们不证明任意规模快照、生产并发、跨区域恢复或企业级迁移。
为什么它不是备份、迁移或灾难恢复
“不是备份”并不是因为功能还不够多,而是三类能力回答的问题不同。
完整备份与恢复
需要覆盖所有权威数据与运行态,定义一致性点,证明凭据、配置、对象存储、数据库和外部依赖如何恢复,还要能演练恢复并验证数据完整性。核心知识副本明确省略运行历史,因此不满足这个合同。
生产迁移
需要版本兼容、schema 演进、数据校验、cutover、双写或冻结窗口、失败 rollback、增量追平和生产流量观察。一个新 Draft 项目能被创建,不代表生产业务可以切换过去。
灾难恢复
需要明确 RPO/RTO、故障域、基础设施恢复、跨区域或跨账户策略、密钥和身份恢复,以及定期演练。单个应用层 JSON 快照无法替代这些能力。
因此,最准确的表述是:“在当前 schema 和受控边界内,将四类核心知识复制到隔离 Draft,并保留预检、映射与 receipt 证据。”这句话比“支持项目恢复”长,却不会给读者和实际使用者留下错误承诺。
六个被拒绝的省事方案
1. compatible=true 只检查 schema
不接受。结构正确不代表 Graph endpoints、Evidence refs 和 lineage 完整。
2. 忽略未知分区
不接受。旧导入器无权判断未来权威状态可以被安全省略。
3. 预览和执行只绑定文件路径
不接受。同一路径的内容可以变化,确认必须绑定 fingerprint。
4. 保留所有旧 IDs
不接受。源项目和副本会争夺同一 authority identity;应重映射身份并单独保存来源血缘。
5. 中途失败统一返回 error,不保存进度
不接受。调用方无法知道目标项目是否已经存在、哪些对象已写入,也无法安全 replay。
6. 为了好卖,把知识副本叫备份恢复
不接受。省略运行历史、没有一致性点、没有恢复演练、没有 RPO/RTO 的能力不能承担这个名称。
这些拒绝项共同塑造了当前实现。工程设计不仅是选择做什么,也包括明确哪些方便的说法和 fallback 会破坏证据。
我在这项能力中承担了什么
修复从“部分导入却显示 compatible”的反例开始:明确复制与省略分区,将用户确认绑定到 fingerprint;新目标使用独立 project/graph 和 authority IDs,并保留 source lineage;重试复用 request identity、确定性目标与 immutable receipt。注入失败后,系统保存 Partial 与已写入数量,供调用者决定如何处理目标副本。
测试设计也围绕最小反例,而不是只写 happy path:unknown section、dangling endpoint、Evidence 引用丢失、fingerprint drift、occupied target、exact replay 和 mid-write failure。前端则把这些合同转成用户在确认前能看懂的 copied、omitted、blocked 与 Draft 语义。
TraceWise 拥有项目 Graph/Evidence、规则、复制工作流和 UI。本文不把逻辑 Graph 隔离归因为生产安全,不把单机 replay 归因为分布式 exactly-once,也不把 Applied receipt 归因为模型质量或生产可用性。
证据范围与当前边界
当前可以严谨地说:已支持从 tracewise.project_snapshot.v1 预检并复制 Entity、Relation、Evidence 和 Rule;未知分区、悬空引用、fingerprint 漂移和目标占用失败关闭;目标是隔离 Draft,源保持不变;authority IDs 被重映射并保留来源血缘;精确 replay 返回同一 receipt;中途失败保存可审计 Partial。
当前不能说:Snapshot 是完整项目备份;Simulation、Agent interactions、报告、活动或 timeline 会被恢复;Partial 会被自动补偿或回滚;graph_id 提供 tenant security;单机重放等于分布式 exactly-once;该路径已经过生产并发、长期流量、跨区域恢复或灾备演练。
核心知识副本最终解决的不是“把一个 JSON 导进去”这么小的问题。它解决的是一种更常见的工程风险:当系统只能可靠复制一部分世界时,如何把这部分做完整,把剩余部分说清楚,并让每一次成功、阻断和失败都有可以回看的证据。
若后续需要完整恢复,必须先列出当前省略的状态,再分别设计导出、重建与恢复验收。