返回 TraceWise 项目总览 · 交互图:产品 · 运行时 · 架构 / 系统 · 架构
AI 产品最容易被忽略的部分,不是模型返回了什么,而是模型调用之前系统选择了什么。
同一个问题,如果输入上下文包含不同版本的实体、不同 Evidence、不同关系邻域或一段陈旧 Memory,最终回答可能完全不同。只在响应底部写一个模型名称,并不能解释这次结果。
TraceWise 因此把 Context 当成产品对象,而不是 Prompt 拼接的内部细节。用户可以先预览将进入分析的节点和引用;后端记录来源、预算、缺口与 fingerprint;真正的模型调用仍由产品拥有的 Host Model 边界负责。
这篇文章回答:怎样让模型输入既有用,又保持有界、可检查和可追溯。
Context 不是“把所有资料都塞进去”
项目 Graph 可能包含大量节点、关系、Evidence、历史和报告。如果每次都把整个项目发送给模型,会同时引入四个问题:
- 输入不可预测,难以复现;
- 重要 Evidence 被大量背景淹没;
- 成本和延迟随项目规模无界增长;
- 用户不知道系统实际依据了哪些内容。
TraceWise 的 Context 请求从一个明确任务开始:用户消息、当前选中节点、显式固定的上下文节点、Project/Graph 作用域以及请求预算。系统对显式节点去重,再由不同 Context Source 提供候选资源。
当前 V2 路径区分:
- Graph Source:节点、关系与项目结构;
- Evidence Source:来源、摘要、revision 与引用;
- 可选 Memory Source:Foundation 公共边界返回的受控记忆上下文;
- Runtime Provider:执行有界组装并生成 diagnostics。
来源分开后,失败也可以被分开描述:Memory 不可用不应让 Graph/Evidence 基线消失;Evidence 缺口不能被一个流畅模型回答掩盖;Graph 来源也不应偷偷取得模型凭据。
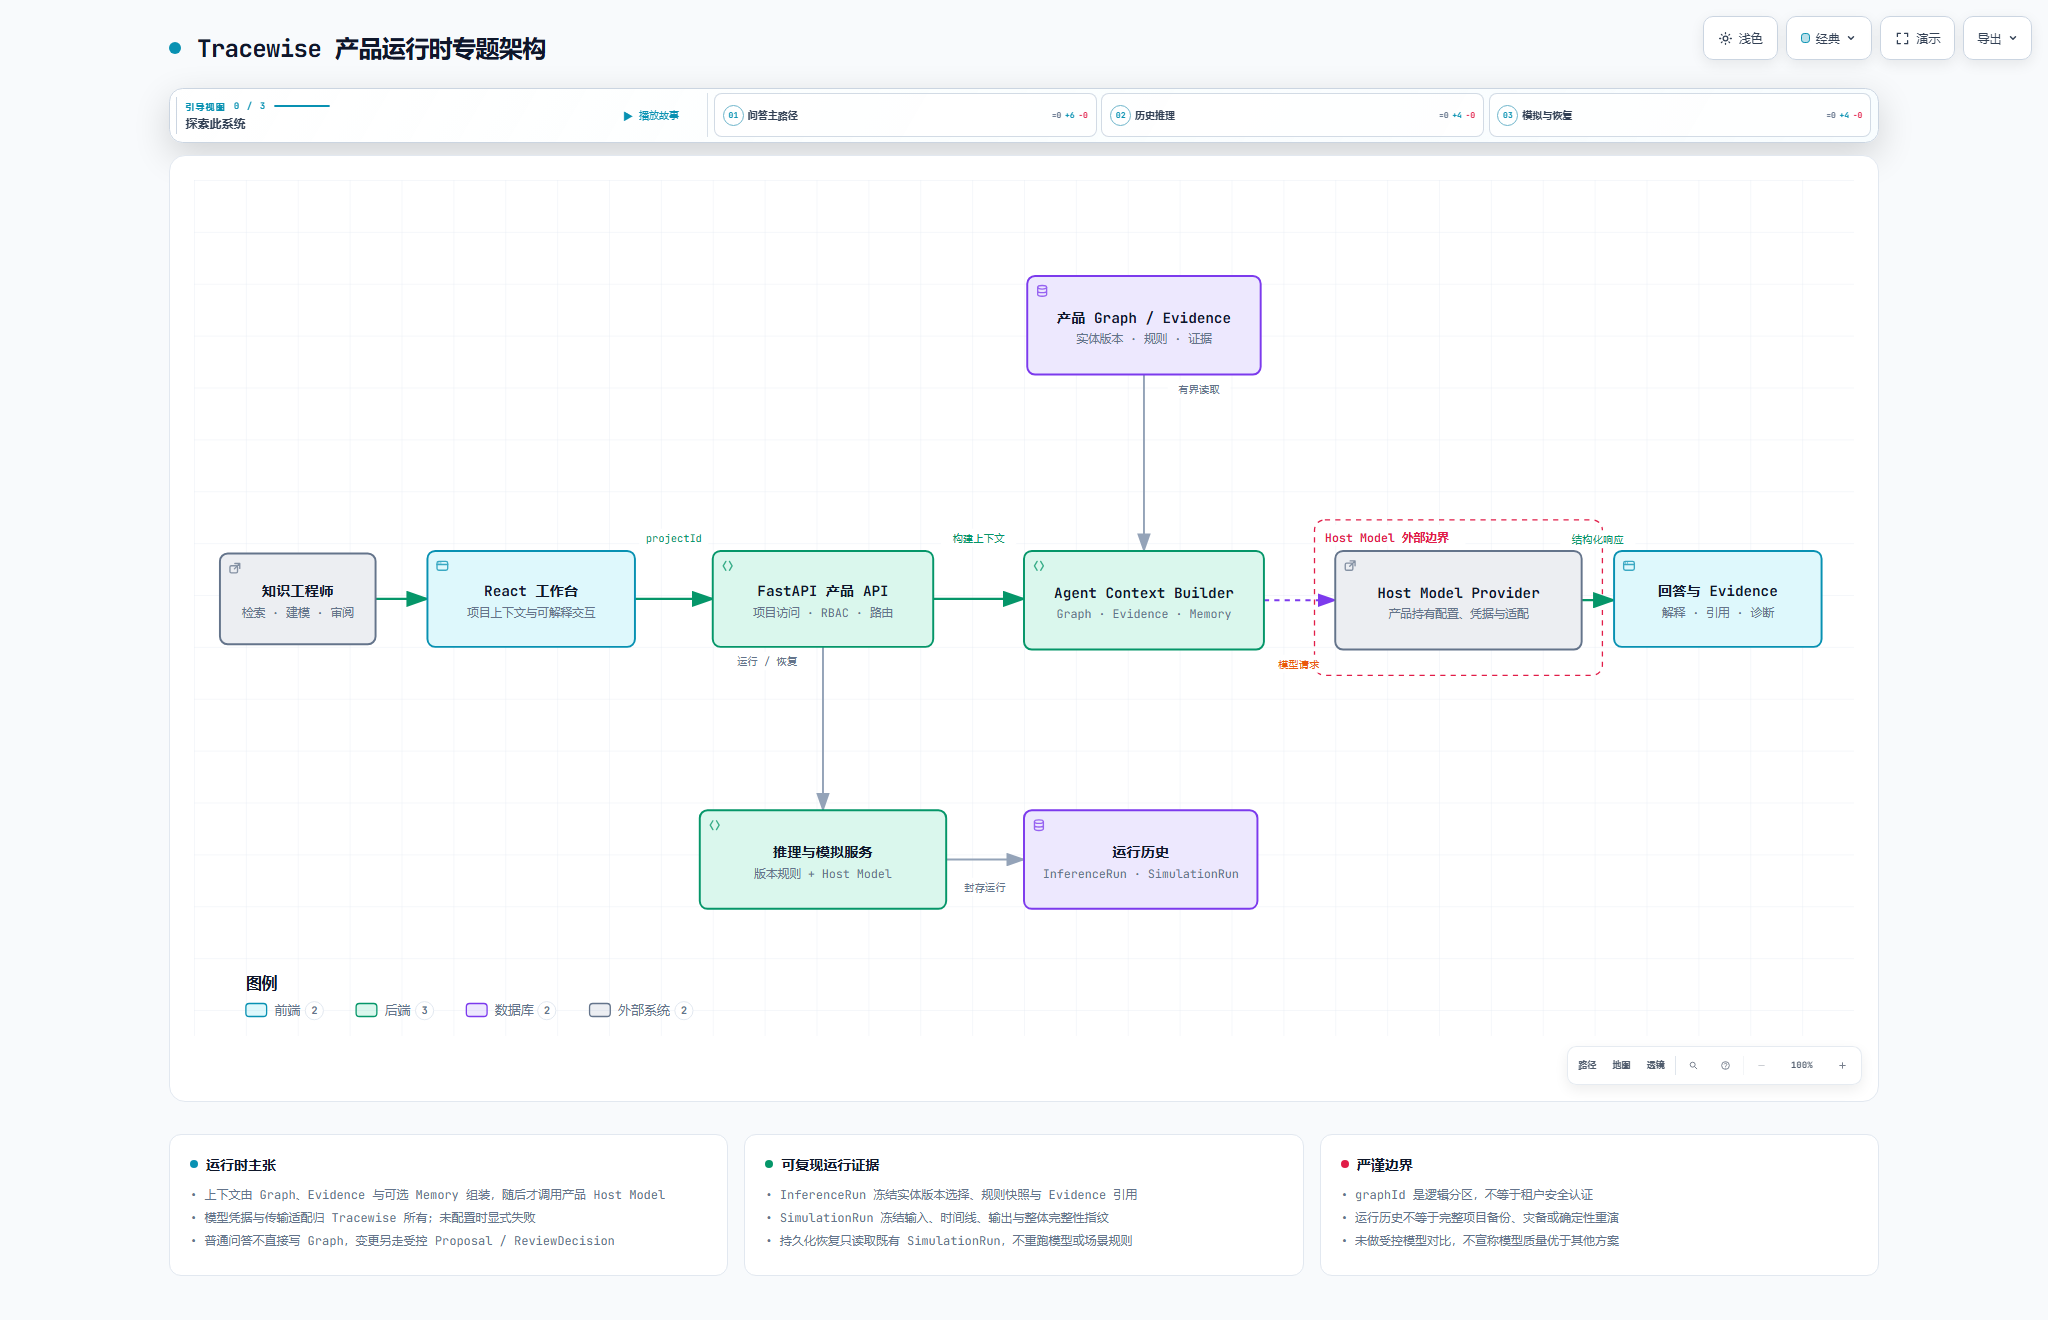
技术解释图:Context 组装位于 Host Model 调用之前,Graph、Evidence、Memory 和模型边界由不同所有者负责。
用户选择与系统扩展必须同时保留
完全自动的检索会让用户失去控制;完全手选又会让分析退化成手工拼资料。TraceWise 同时保留三层输入:
- 用户当前选中的主节点;
- 用户显式固定的 Context Node IDs;
- 系统依据查询和 Graph 关系扩展出的候选。
Diagnostics 会记录 selected node、explicit context IDs、expanded node IDs、最大节点数、最大引用数和实际引用数。这样用户能够区分“我明确指定了什么”和“系统替我扩展了什么”。
前端 AgentContextPreviewPanel 在模型调用前展示节点、citations、Evidence chain 与缺失 Evidence 节点。发现缺口时,用户可以返回实体工作台补 Evidence,或者继续分析但保留警告。
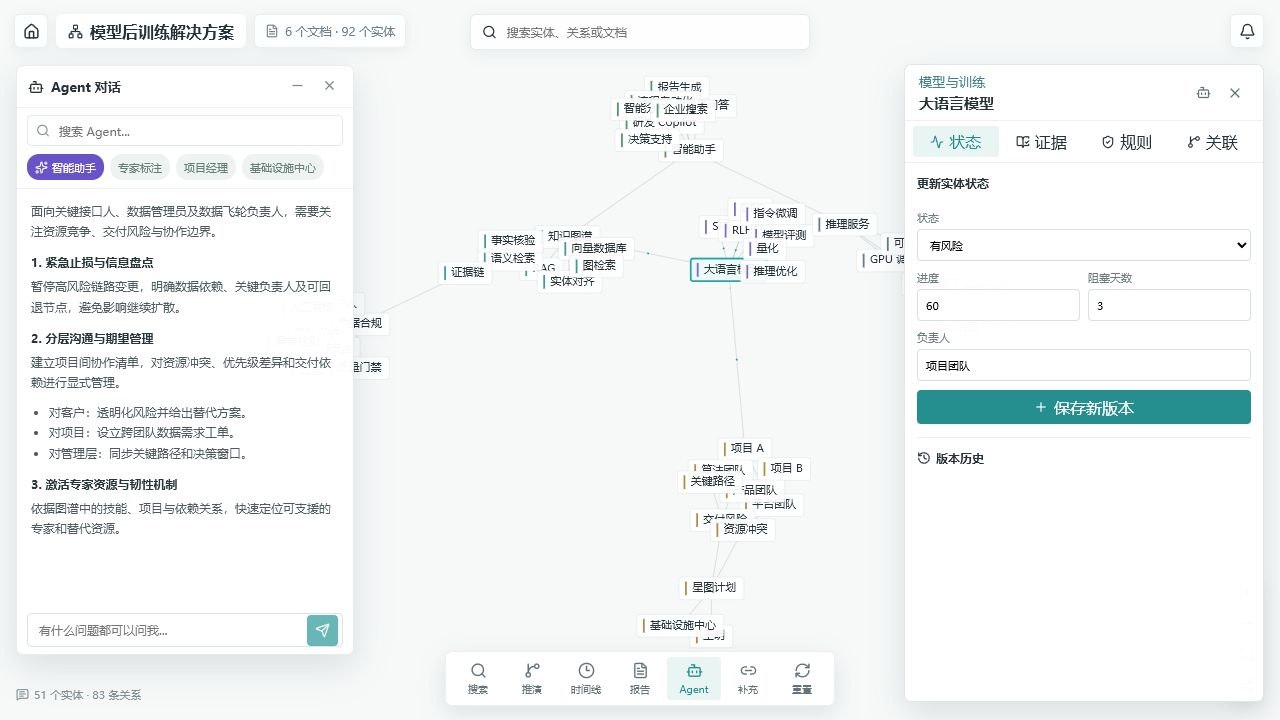
真实产品截图:模型调用前的项目上下文、Persona 和分析任务位于同一工作台;数据为合成示例。
预算是上下文契约的一部分
“只取 Top-K”还不够。不同资源占用的字符数、引用数和解释成本不同。当前 Context V2 接收显式预算,并在组装时限制资源数量与字符总量。
有界组装需要回答:
- 请求预算是什么;
- 实际选择了哪些资源;
- 哪些候选因为预算被截断;
- 每个来源是否成功、降级或缺失;
- 组装结果的 fingerprint 是什么。
fingerprint 不能证明内容正确,但能固定“这次模型看到的上下文是哪一份”。如果后续形成 Proposal、报告或历史记录,系统可以把结果与输入版本联系起来,而不是只保留一段不可复现的聊天文本。
Evidence citation 与 Evidence chain 不一样
Citation 是某条来源的直接引用;Evidence chain 则按 Graph 节点组织引用,表达某个项目对象有哪些依据。TraceWise 在 Context 结果中同时保留:
- citations:来源、excerpt、confidence、revision 等;
- evidence chain:节点与其 Evidence 集合;
- missing evidence IDs:进入上下文但缺少依据的节点。
这样,模型可以引用具体来源,用户也能检查“一个结论依赖的节点是否都有证据”。但 confidence 仍然只是来源字段或工程信号,不代表模型答案正确率。
为什么 Host Model 必须由 TraceWise 拥有
TraceWise 采用 Agent Foundation 的公共能力,但没有把模型控制权交给平台。产品继续拥有:
- Host Model provider 选择;
- 凭据读取和隔离;
- Prompt 与 Persona 指令;
- 对话历史;
- Graph/Evidence 产品上下文;
- 是否允许模型输出进入 Proposal 的业务规则。
Foundation 可以参与 Context、Memory 或权威执行,但只通过 agent_foundation.public.*。它不接收产品凭据,也不取得 TraceWise Prompt、Review UI 或 Graph/Evidence 业务真相的所有权。
既有 Host Model 验收还检查了两个关键字段:credentials_exposed=false 与 mutation_authorized=false。这意味着一次模型调用的 receipt 明确记录:凭据没有暴露给调用结果,模型响应本身也没有获得写入产品权威的许可。
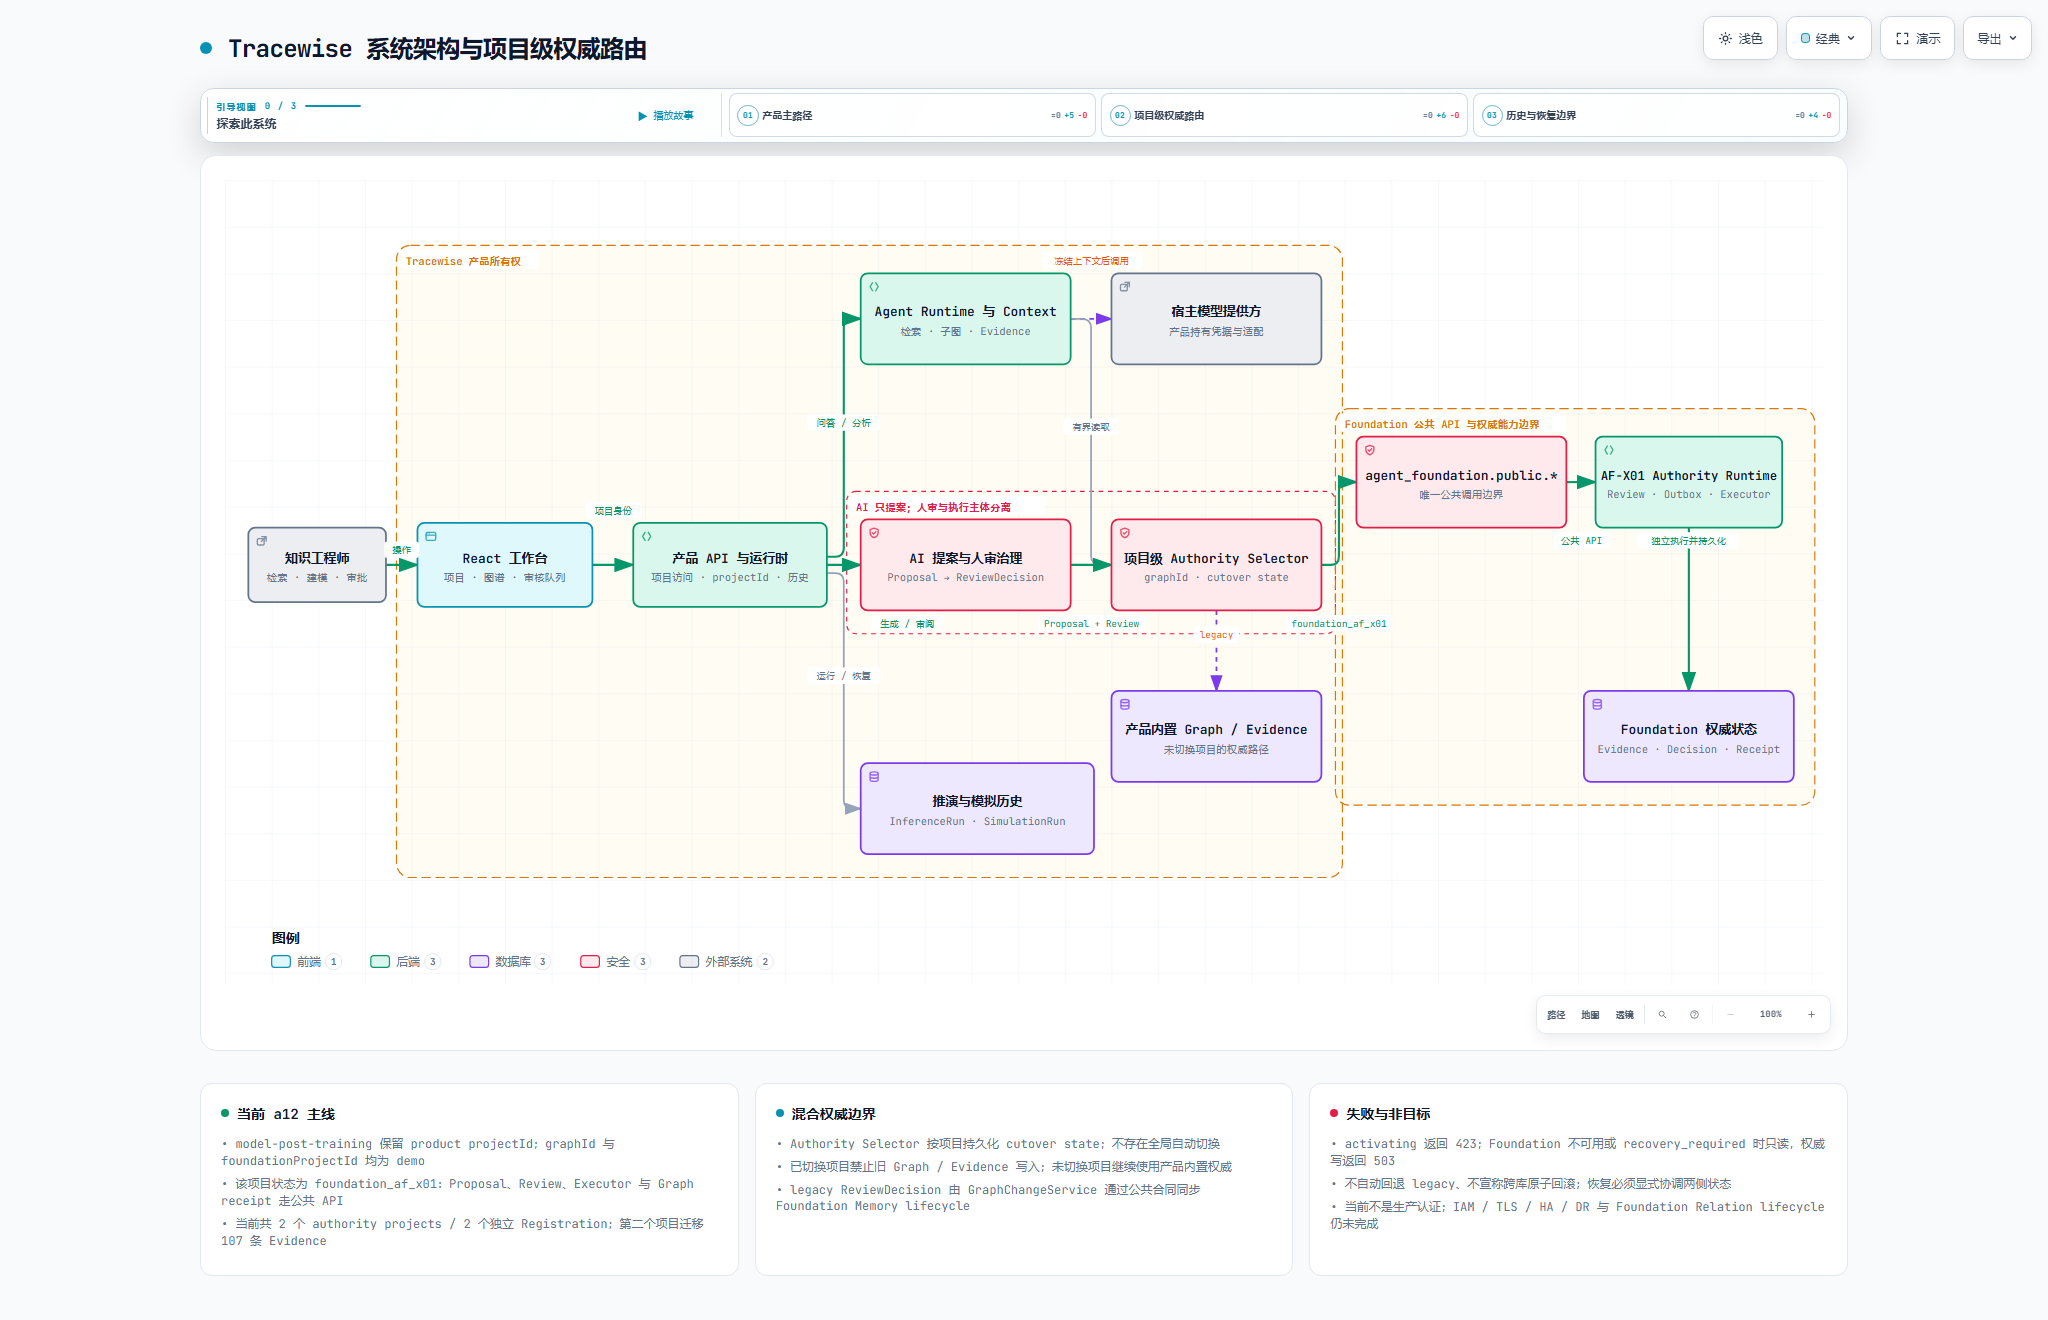
技术解释图:Host Model、Prompt、Graph/Evidence 和用户体验属于 TraceWise;Foundation 通过公共 API 提供受控能力。
模型不可用时,哪些能力仍应存在
如果 Context、Graph 浏览、Evidence 检查和历史读取都依赖模型在线,产品就没有真正的基础能力。TraceWise 将这些路径分开:
- Graph 与 Evidence 可以直接读取;
- Context 可以预检并报告缺口;
- 已持久化 Simulation 可以 restore;
- ReviewDecision 和历史状态可以查看;
- 模型不可用时,新的生成式回答失败或降级,但不会假装成功。
这不是完整的离线产品承诺,而是所有权边界:Host Model 是产品调用的一个受控依赖,不是所有产品状态的唯一入口。
这套设计没有证明什么
当前证据确认 Context 来源、预算、diagnostics、preview、Host Model receipt 和公共依赖边界存在。它没有证明:
- 当前 Context 选择能让某个模型更准确;
- Memory 加入后一定优于只用 Graph/Evidence;
- Persona 稳定提升任务结果;
- 当前预算适合所有项目规模;
- Host Model 已达到生产 Secret 管理、可用性和容量要求。
模型质量需要独立评测,生产 Secret、IAM、TLS、容量和故障演练也属于单独认证范围。
最终设计原则
Context Engineering 不是“Prompt 写得更长”,而是把模型输入变成一个有来源、有预算、有缺口、有版本的产品契约。
TraceWise 的顺序是:先确定任务和作用域,再组装 Graph/Evidence/可选 Memory,先让用户检查,最后由产品拥有的 Host Model 执行。 模型可以生成回答,但不能决定自己看什么、不能读取产品凭据,也不能因为回答流畅就自动获得写入权。