“最终由人负责”是一句正确但不够用的话。
如果系统没有说明人审核了哪份内容、参考了哪些 Evidence、当时 Graph 是哪一版、审核后依据是否变化,那么一个确认按钮并不能自动形成责任。它最多证明某个人点过一次按钮。
TraceWise 对这个问题的回答不是让模型承担责任,也不是把所有风险推给 Reviewer,而是把一次 AI 建议拆成几段所有权明确的过程:模型只能生成候选内容,产品负责把候选内容绑定到业务事实和权限上下文,Reviewer 只对自己实际看到的冻结依据作决定,执行器在写入前重新检查当前状态,Foundation 则独立守住自己的公共 Authority 合同。
这套设计证明的是责任路径可追踪,不是 AI 已经正确,也不是系统已经获得生产治理认证。
“人在回路中”为什么仍可能是假控制
以下几种实现都有人工步骤,但仍不足以形成有效治理:
- 页面显示一段模型文本,只有“同意”按钮,没有 Proposal 的结构化差异;
- 审核人看到的是旧 Evidence,执行时系统使用了新 Evidence;
- 前端可以自己填写 reviewer identity,后端无法确认实际调用者;
- 一个
approved=true被重复用于不同 Project 或 Scope; - Graph 已写入、下游平台失败,但页面仍显示“全部成功”;
- 模型可以绕过审核,直接调用原始数据库写入工具。
因此,人的存在不等于控制成立。控制成立至少需要回答:谁在什么上下文中,对哪一份不可混淆的对象,授予了哪一种有限权力;当上下文变化时,这份权力怎样失效。
NIST 的 AI Risk Management Framework Core 把角色、责任和沟通线路的明确化放在 Govern 中,也要求区分 human-AI 配置中的职责,并根据上下文、风险和影响持续 Map、Measure、Manage。这不是 TraceWise 的合规认证,但它支持一个重要判断:AI 治理不是最后加一个人工审批,而是贯穿目标、角色、测量、运行和反馈的责任结构。
TraceWise 的六个责任主体
下面这张表描述的是当前产品责任模型,不是某家企业已经部署的组织架构。
| 主体 | 可以做什么 | 不能据此做什么 | 需要留下什么 |
|---|---|---|---|
| 项目调查者 | 提出问题、选择 Project/Graph、查看 Context 和 Evidence | 不能因为看见回答就直接改变权威状态 | 查询上下文、引用、选择范围 |
| Host Model | 生成回答、解释或结构化 GraphChangeProposal | 不能决定自身输出为事实,不能获得原始数据库写权 | 结构化候选输出和引用 |
| TraceWise 产品 | 拥有业务 Project、Graph、Evidence、Prompt、Reviewer 流程和 Host Model 配置 | 不能把 Foundation 内部状态冒充产品事实,也不能替生产 IAM 授权 | Proposal、Context、版本、ReviewDecision、产品 receipt |
| Reviewer | 对当前展示的 Proposal、Evidence 和业务理由批准或驳回 | 不能批准后来漂移的 Proposal/Graph/Evidence,不能证明模型质量 | 身份、决定、理由、时间和冻结依据 |
| GraphChangeService | 重读权威状态、验证决定、幂等执行产品 Graph 变更 | 不能跳过 ReviewDecision,也不能把下游失败伪装成未发生 | 执行结果、冲突、stale 或 pending 状态 |
| Agent Foundation | 根据自己的 Registration、Scope、Evidence、Policy 和资源状态处理公共 Memory/Authority 合同 | 不拥有 TraceWise 的产品工作流、Prompt、业务 Graph 或 Reviewer UI | Foundation authorization、transition 和 receipt |
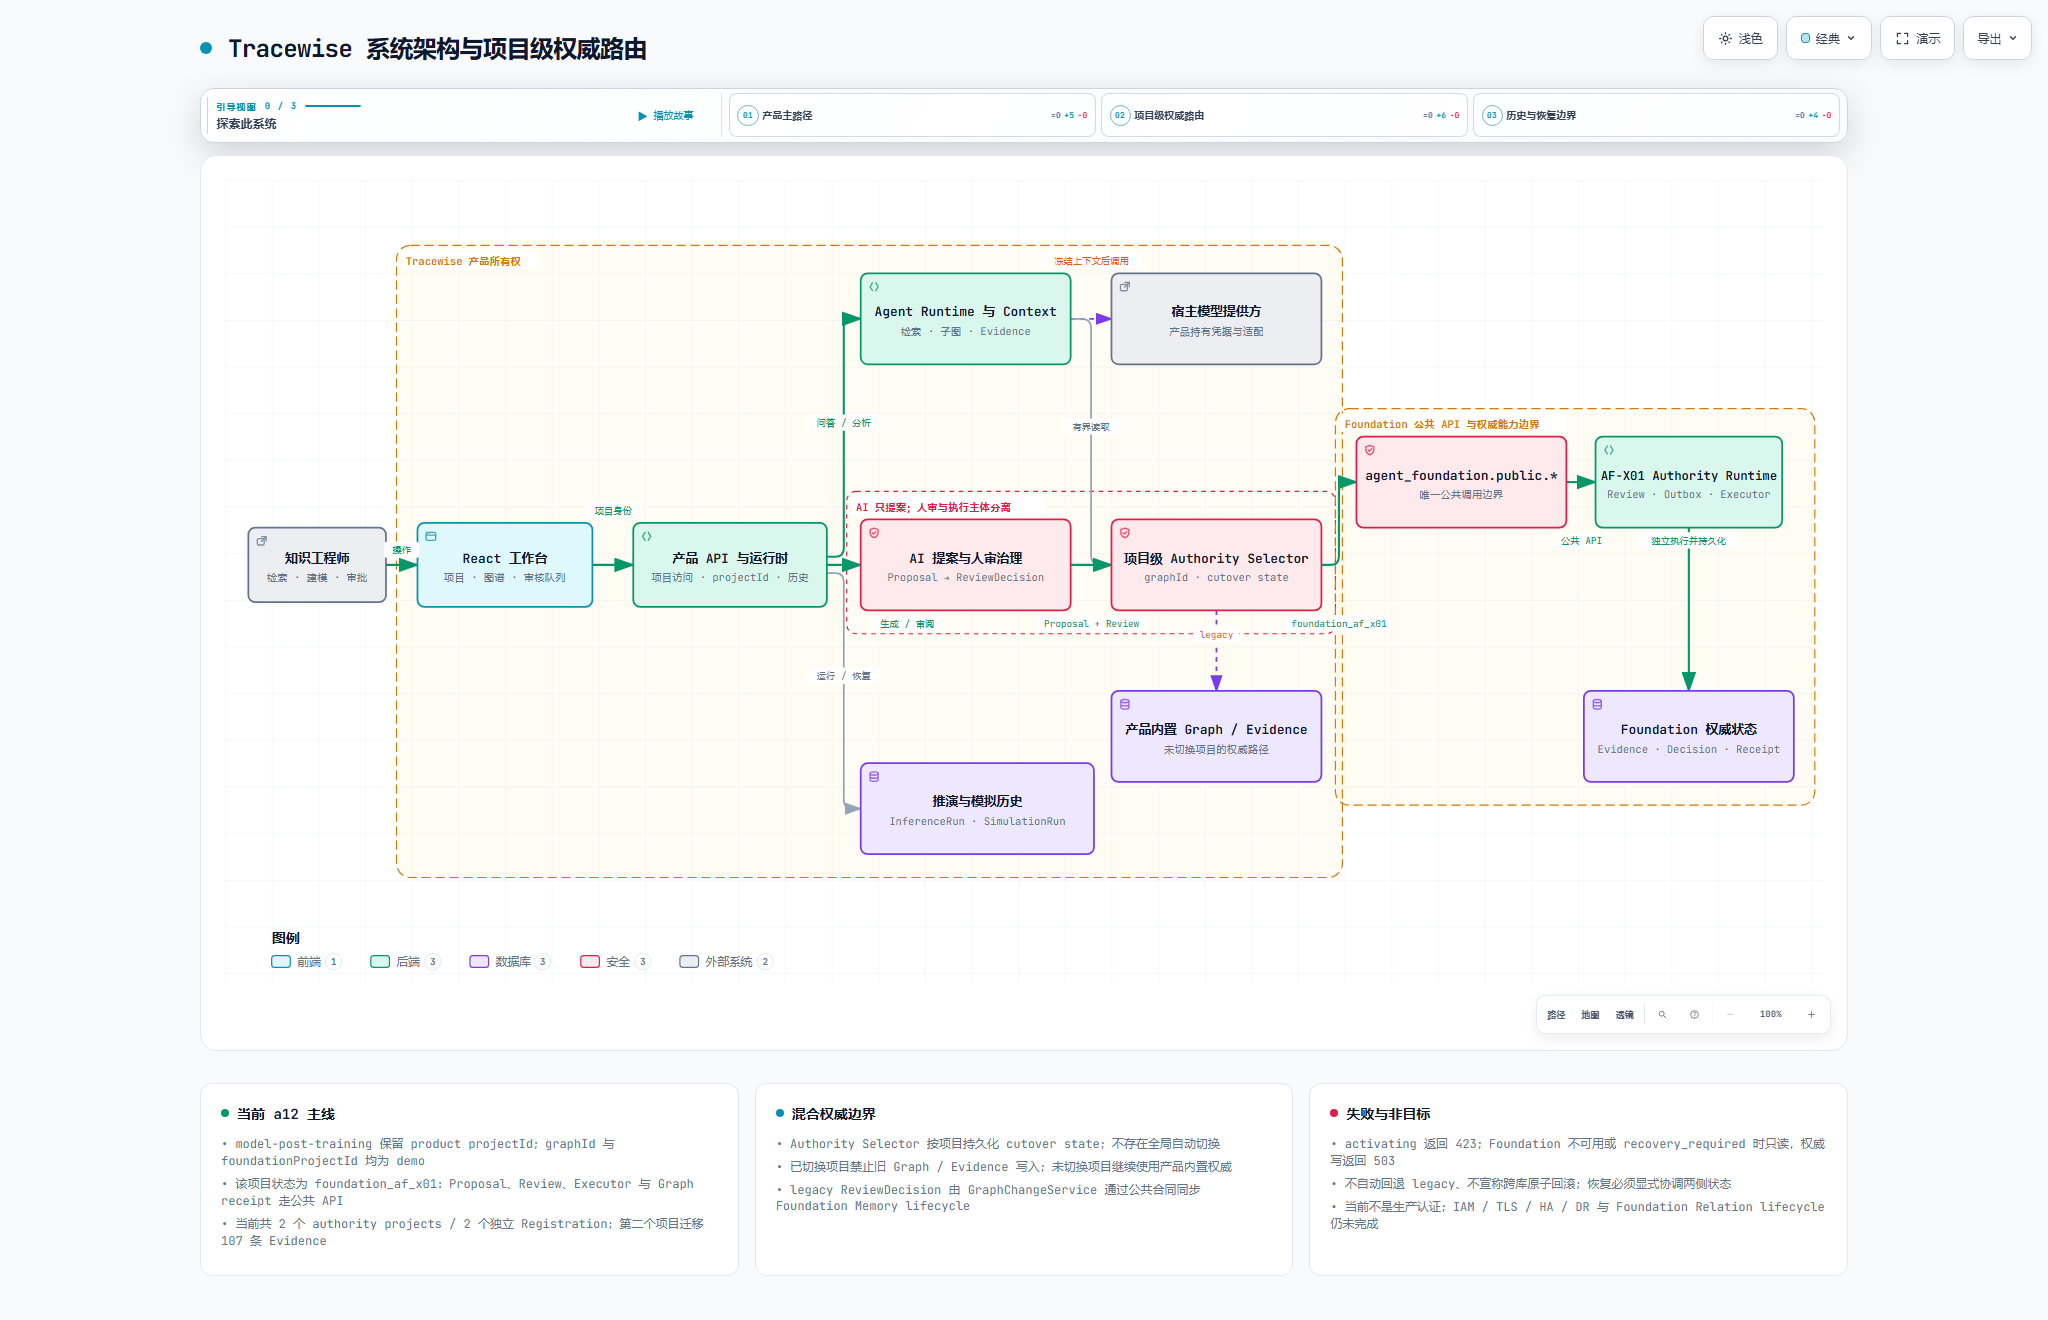
技术解释图:共享基础设施不等于转移业务责任。该图解释组件边界,不证明生产 IAM 或租户安全。
模型为什么只能生成 Proposal
模型擅长提出候选解释,也会生成错误、遗漏和格式漂移。如果它直接修改权威 Graph,系统就无法稳定区分“模型认为”与“项目已经确认”。
TraceWise 将模型输出限制为 GraphChangeProposal。Proposal 首先通过 schema 校验,然后进入产品审阅流程。在这个阶段,它仍然是非可信候选,不因为模型语气自信、confidence 数字更高或使用了多个 Persona 而获得执行权。
这个边界同时保护模型和用户:模型不需要假装承担它无法承担的组织责任,用户也不会把一段生成文本误认为已经生效的业务事实。
Reviewer 审核的不是一句结论,而是一份冻结信封
一次 tracewise.review-decision.v1 绑定的不是简单布尔值,而是一组共同定义授权范围的字段:
- Project、Graph 和逻辑 Scope;
- 已保存 Proposal 及其 fingerprint;
- 提案时 Graph revision 和 fingerprint;
- Evidence IDs 和 Evidence fingerprint;
- Policy revision;
- Reviewer identity;
- approve/reject、业务理由和时间;
- replay identity。
Reviewer 的身份从已认证访问上下文推导,不由普通 UI 任意填写。真正执行前,服务重新读取 Proposal、Graph、Evidence 和当前决定。Proposal 被替换、Graph 或 Evidence 漂移、Policy 过期、Reviewer/Project/Scope 不一致,都会在产品 Graph 或 Foundation Authority 写入前失败关闭。
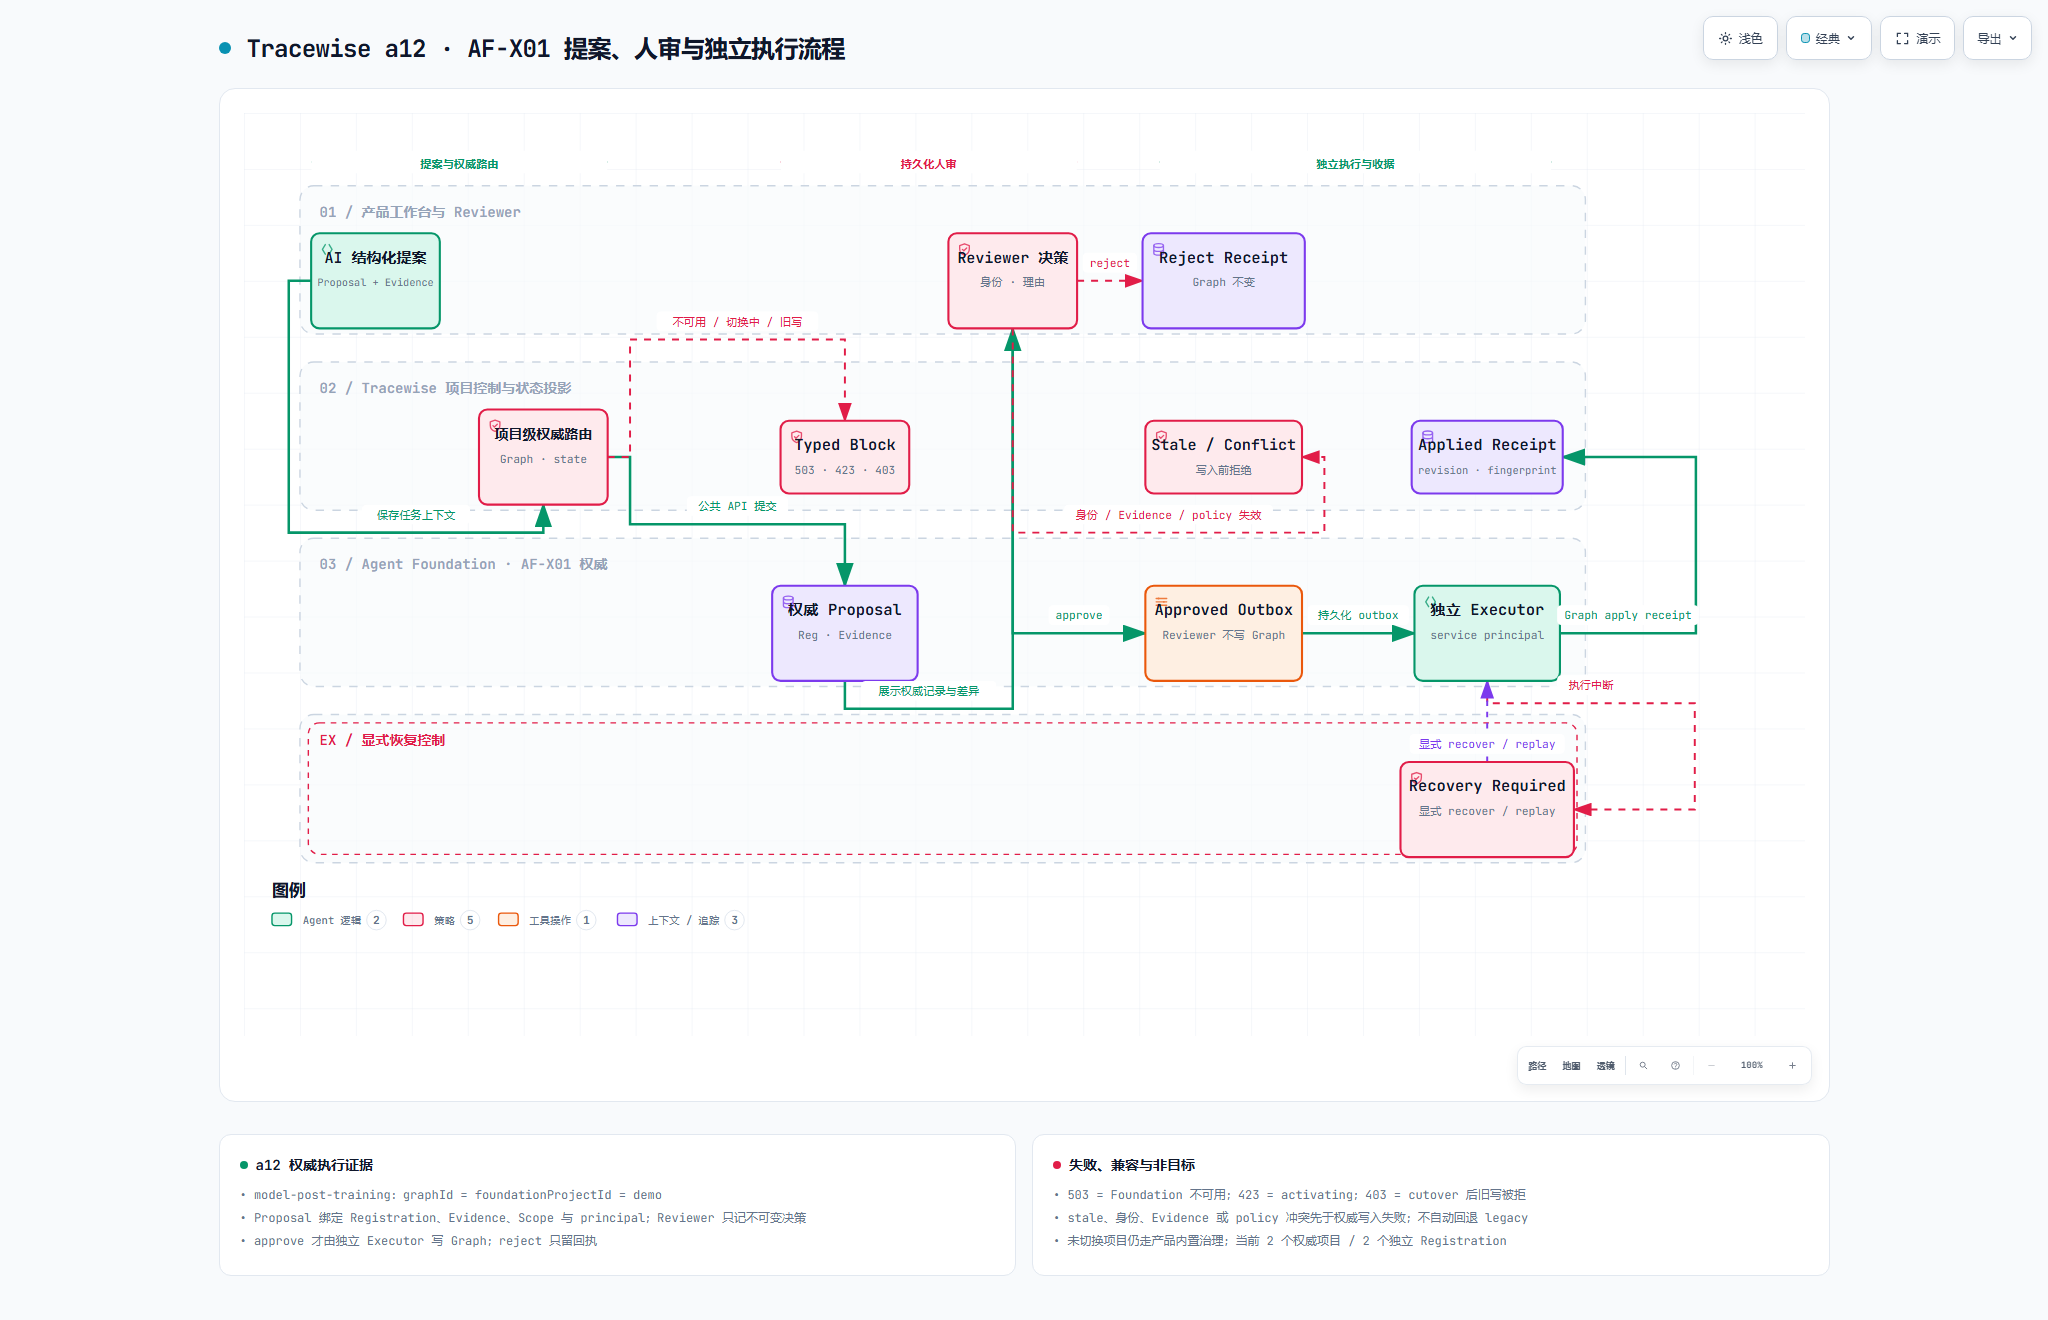
技术解释图:批准只授权审核过的冻结依据,不授权后来漂移的内容。
这带来一个重要的责任结论:Reviewer 不是为模型的所有未来输出负责,只对当时可见、可标识、可追溯的这份候选变更作决定。
Evidence 变化后,为什么旧批准必须失效
假设 Reviewer 批准了一项“将支付网关状态改为高风险”的 Proposal。批准依据包含三条 Evidence。审核完成后,其中一条 Evidence 被撤回,Graph 中相关服务也完成了修复。
如果系统继续执行旧决定,就等于把后来变化的事实偷偷放进了原审批。这里真正被破坏的不是“数据一致性”这个抽象词,而是授权对象的一致性:Reviewer 审核的事实集合与系统准备写入时的事实集合已经不同。
因此 TraceWise 不自动拼接新 Evidence,也不让旧批准继续生效。它返回 stale,要求重新形成或重新审核。这会增加操作,但避免把审阅过程变成一次无限期授权。
产品与平台为什么都要独立验证
TraceWise 与 Agent Foundation 的集成不是“产品调用平台,所以平台替产品负责”。两侧拥有不同事实:
- TraceWise 知道业务 Project、Graph、Proposal、产品 Evidence、Reviewer 和产品执行语义;
- Foundation 知道自己的 Registration、Scope、Memory resource、Evidence admission、Policy 和 Authority lifecycle。
同一次产品决定可以被映射成 Foundation 的公共授权提交,但 Foundation 仍要独立验证自己的绑定。它不信任 TraceWise 对其内部资源的推断,TraceWise 也不导入 Foundation store、repository、provider、container 或数据库实现来绕过公共边界。
这也是物理拆分的理由之一。两个 Python distribution 曾共享顶层 app namespace,安装顺序可能覆盖文件。拆分后 Foundation 独占 agent_foundation.*,TraceWise 保留产品 app.*,并只通过精确版本的 agent_foundation.public.* 集成。包边界解决的是可复制所有权,不自动证明生产可用性。
部分成功时,谁负责说真话
跨系统动作最容易在这里失去责任。
受控验收曾让 TraceWise Graph 成功写入,再让 Foundation PostgreSQL 真实不可用。系统没有跨 Graph、SQLite 和 PostgreSQL 的统一原子事务,Graph 的已提交写入会保留。
TraceWise 保存 applied_with_foundation_pending,把已经发生的产品 Graph 结果、失败的 Foundation 同步和原 ReviewDecision 绑定起来。数据库恢复后,用户显式重试同一个决定;成功更新同一 sync record,再次重试得到 deduplicated。
这里的责任分配是:
- TraceWise 负责承认产品写入已经发生;
- Foundation 负责返回自己的 typed failure 或 receipt;
- 用户负责决定何时重试,而不是被一个虚假的绿色成功提示误导;
- 系统共同负责保证重试仍指向同一个不可变决定。
当前验证覆盖同一决定的手动重试与去重,其他跨存储故障组合及自动恢复仍需分别验证。
“谁负责”还必须包含“谁无权负责”
责任边界不只分配任务,也拒绝不应承担的任务。
Host Model 无权决定事实
模型只拥有候选输出,不拥有 Graph、Evidence、Policy 或审批状态。confidence 也不是正确率许可证。
Foundation 无权决定产品目标
Foundation 提供公共治理和 Authority 合同,但不拥有 TraceWise 的业务角色、Prompt、Host Model 凭据、页面或项目真相。
Reviewer 无权跨越证据漂移
Reviewer 的一次决定只对冻结的 Proposal 和 Evidence 生效,不是对某个模型、项目或未来变更的永久授权。
开发者无权把本地验收写成生产认证
两个受控本地项目、真实 PostgreSQL/Neo4j、浏览器和重启验收能够证明明确路径,但不能替代生产 IAM、TLS、Secrets、HA/DR、真实流量或组织制度。
人审机制自身也需要被验证
“有人审”是一条产品声明,也需要证据。TraceWise 当前验证的重点包括:
- approve 写 Graph 一次,reject 不写目标 Graph;
- exact replay 幂等,反向终态决定冲突;
- direct apply 返回
review_decision_required; - wrong reviewer/project/Scope、Proposal tamper、Graph/Evidence drift 和 stale policy 在写前失败;
- Foundation outage 保留 pending,同一决定可手动 retry;
- Relation-only 反例证明当前 Foundation 只消费 Memory,而不是 Relation lifecycle。
这些证据说明控制流按当前合同运行,不说明 Reviewer 判断一定正确。审阅质量仍取决于证据是否充分、角色是否具备业务能力,以及组织是否真的执行了制度。
四个容易被误解的治理边界
既然最终是人批准,AI 的价值在哪里?
AI 帮助形成候选解释、关联上下文和结构化 Proposal;人的价值是承担业务判断并授权具体变化。系统的价值不是替代其中一方,而是让两者之间的 Evidence、版本和责任可追溯。
为什么不能让低风险修改自动执行?
可以,但必须由产品 Policy 明确分类风险,并仍然通过可追溯 Authority 合同。TraceWise 当前 Graph Proposal 路径选择人审;其他个人 Memory 场景可以为低风险显式记忆配置自动批准,两者不能互相推导。
这是否满足企业 AI 治理或合规要求?
不能这样说。当前是一个受控本地产品合同,NIST AI RMF 只是分析框架。生产身份、组织责任、访问控制、审计保留、监管适用性和运行监测都需要独立认证。
Foundation 失败后为什么不自动重试?
自动重试会改变运维和风险边界。当前产品保存 pending,并允许显式重试同一个冻结决定。是否引入后台自动恢复,需要新的调度、退避、告警、停止和责任合同,不能因为技术上容易就默认启用。
结语
AI 系统中的责任不是一句“最终由人承担”,而是一组可以检查的约束:谁能提出、谁能看见、谁能批准、批准了什么、依据何时失效、谁执行、失败后谁保存真实状态。
TraceWise 当前能够证明的是:模型建议与权威写入被分开,一次批准绑定具体 Proposal、Graph、Evidence、Policy、身份和 Scope,产品与 Foundation 独立验证各自 Authority,跨存储失败不会被包装成原子成功或回滚。
它不能证明 Reviewer 永远正确、模型质量提升、企业合规完成或生产系统安全。但正因为这些边界被保留,“谁负责”才从一句口号变成了可以审阅的系统合同。