一份课程生成出来了,内容完整,页面也能播放。对生成接口而言,这可能已经是一次成功;对老师而言,还有许多事情没有发生:内容是否适合这个班,哪里需要修改,学生用了之后会遇到什么问题?
类似的落差也会出现在报告、方案和分析工具里。AI 交付了一个看起来完整的结果,用户却还要把它带入自己的工作,承担选择和使用的后果。
因此,我在看一个 AI 产品时,会把生成之后的过程也纳入设计:人如何理解输出,怎样决定是否采用,遇到问题时怎样修正,最后又依据什么判断它有用。
先确定希望改变的结果
Google PAIR 的《People + AI Guidebook》建议先识别用户问题和既有工作流,再判断 AI 能否带来独特价值;它也区分代替人执行任务与增强人的能力,并要求考虑长期用户收益。User Needs + Defining Success
将这个视角用于教学产品,可以得到两种不同的目标。一个工具希望帮助教师更快得到可编辑的课程初稿;另一个工具希望学生逐渐能够独立处理某类问题。它们都可能生成文字,但成功条件不应一样。
对前者,初稿的适用性、修改负担和后续使用很重要;对后者,系统替学生多完成一步,未必就是目标向前了一步。这些是需要验证的产品假设,不能只用生成数量统一衡量。
我认为,定义输出之后,还应该补上一句:用户拿到它以后,需要完成什么?这句话往往比新增一种生成形式,更能帮助我们决定产品下一步该做什么。
自动化的范围,需要落到具体动作
“保留人工控制”听起来很合理,但如果没有说明人到底控制什么,就很容易落成一个形式上的确认按钮。
以课程为例,教师可能愿意让系统整理结构、提出示例,却仍需要决定是否适合当前学生、是否用作测验,以及何时发布。这些动作承担不同后果,自动化程度也可以不同。
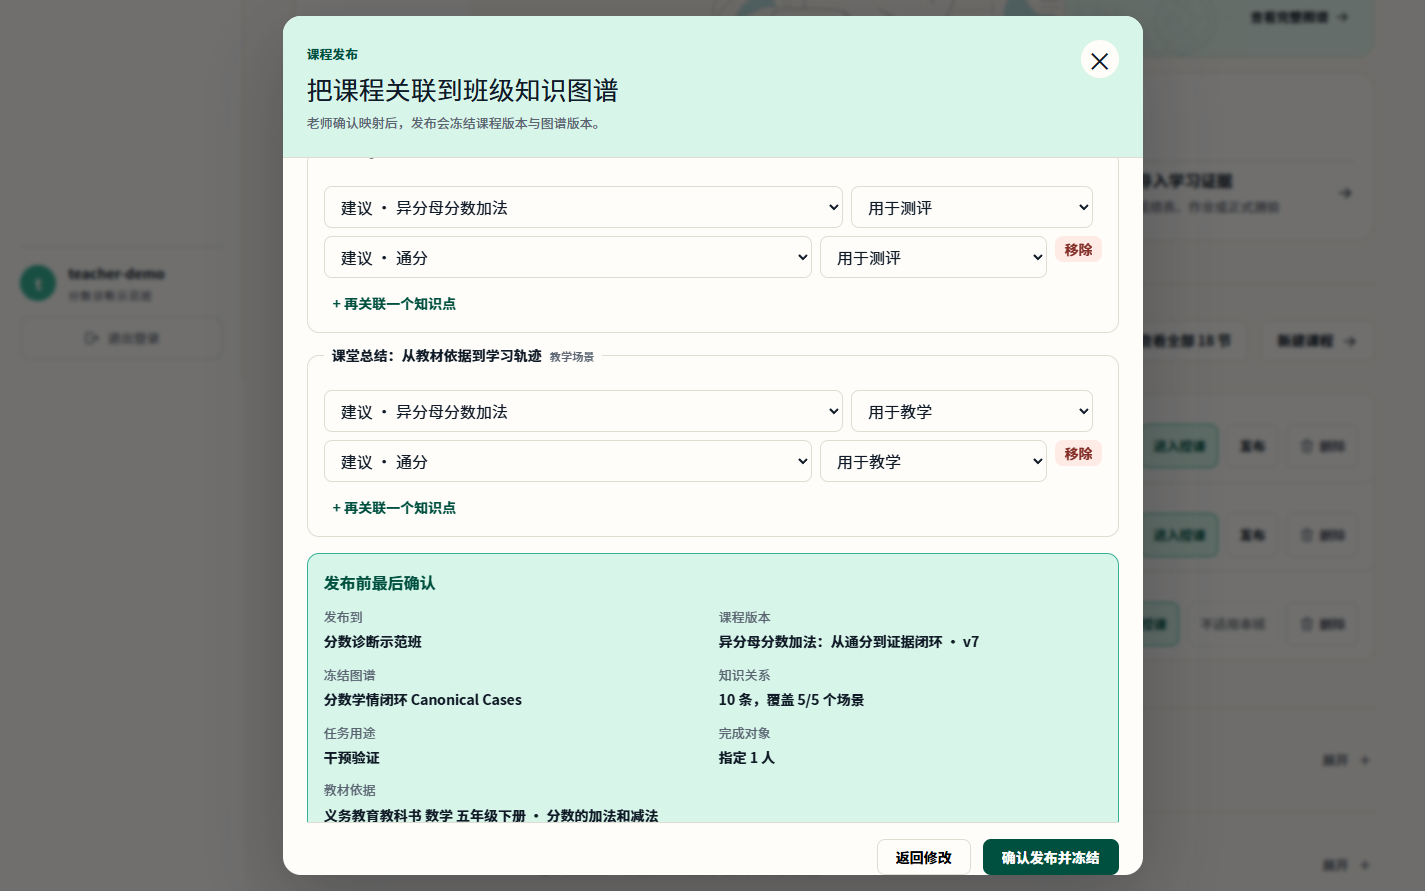
TeachFlow 早期本地演示中的确认界面。它作为一个具体例子,展示生成内容如何交给教师核对,图中信息为合成数据。
这个例子带来的判断是:确认应放在会改变后续行为的地方,并提供足够的信息让人作出选择。如果用户既看不清将发生什么,又无法修改结果,增加一个“确认”按钮并不会自动形成有效控制。
保留这些动作也有成本。每一次核对都会占用注意力,过多步骤可能让用户机械点击。哪些动作值得确认,需要根据后果、可恢复性和用户任务判断,不能把某个项目的做法当作所有 AI 产品的统一流程。
出错以后能否继续,也是产品能力
微软研究团队在 CHI 2019 的《Guidelines for Human-AI Interaction》中,提出支持用户纠正 AI 的错误,并在无法确定用户目标时澄清或适当缩小服务范围。这里引用的是 G9、G10 两项设计指南。论文原文,表 1
这为“出了错怎么办”提供了一个比重新生成更宽的视角。
在我们的教学任务里,如果教师只想调整题量,产品应该让他看清当前建议、修改具体条件,再核对结果。当自然语言理解不稳定时,明确选择题数或学生名单也可以成为可用的操作通道。这样的选择保留了执行路径,并没有消除模型理解上的缺陷。
据此,我会把恢复能力看作产品体验的一部分:用户是否知道哪里没有完成,是否能保留已经有效的工作,以及接下来能采取什么动作。这比要求用户猜测系统内部发生了什么更有意义。
输出、采用与结果,需要分别观察
为了避免把技术完成直接当成用户收益,可以沿着结果被使用的过程提出三类问题:
| 观察位置 | 需要回答的问题 | 可能收集的证据 |
|---|---|---|
| 输出形成 | 内容能否理解、检查和修改? | 错误类型、修改过程、可用性观察 |
| 用户采用 | 人是否把它带进实际任务? | 采用或放弃的原因、后续操作 |
| 使用结果 | 原来的问题是否得到改善? | 对应任务结果、比较条件、持续观察 |
这张表是本文用于分析产品的方式,不是某项研究规定的统一指标体系。具体衡量仍取决于任务。
TeachFlow 的本地记录可以帮助核对发布、作答和反馈等流程是否成立,但不能据此得出教师节省了多少时间、学生提高了多少成绩。要得到后两类结论,仍需要实际使用与适当的评估设计。
这种区分也影响我们怎样安排开发。流程尚未接通时,先修复用户走不下去的环节;流程可以完成之后,就应该逐步把注意力移向采用原因和使用结果,而不是只继续扩展输出类型。
哪些复杂度值得保留
教学内容会修订,已经发生的作答却需要能回到当时的题目。这是 TeachFlow 保留版本与来源的一项原因。它解决的是解释历史行为的问题,而不是为了让系统多一层结构。
同样的判断方式可以用于其他产品:如果省掉某项记录,会不会让用户无法理解已经发生的结果?如果省掉某个选择,会不会让人失去必要的控制?如果不会,就不应只因为架构看起来完整而保留复杂度。
AI 产品的成熟度可以从这里继续观察:生成越来越容易之后,用户能否理解、采用、修改并追溯这些结果。真正需要承担的设计工作,往往就藏在这些后续动作里。