返回 TeachFlow 项目总览 · 交互图:QUESTION · OCR · 血缘
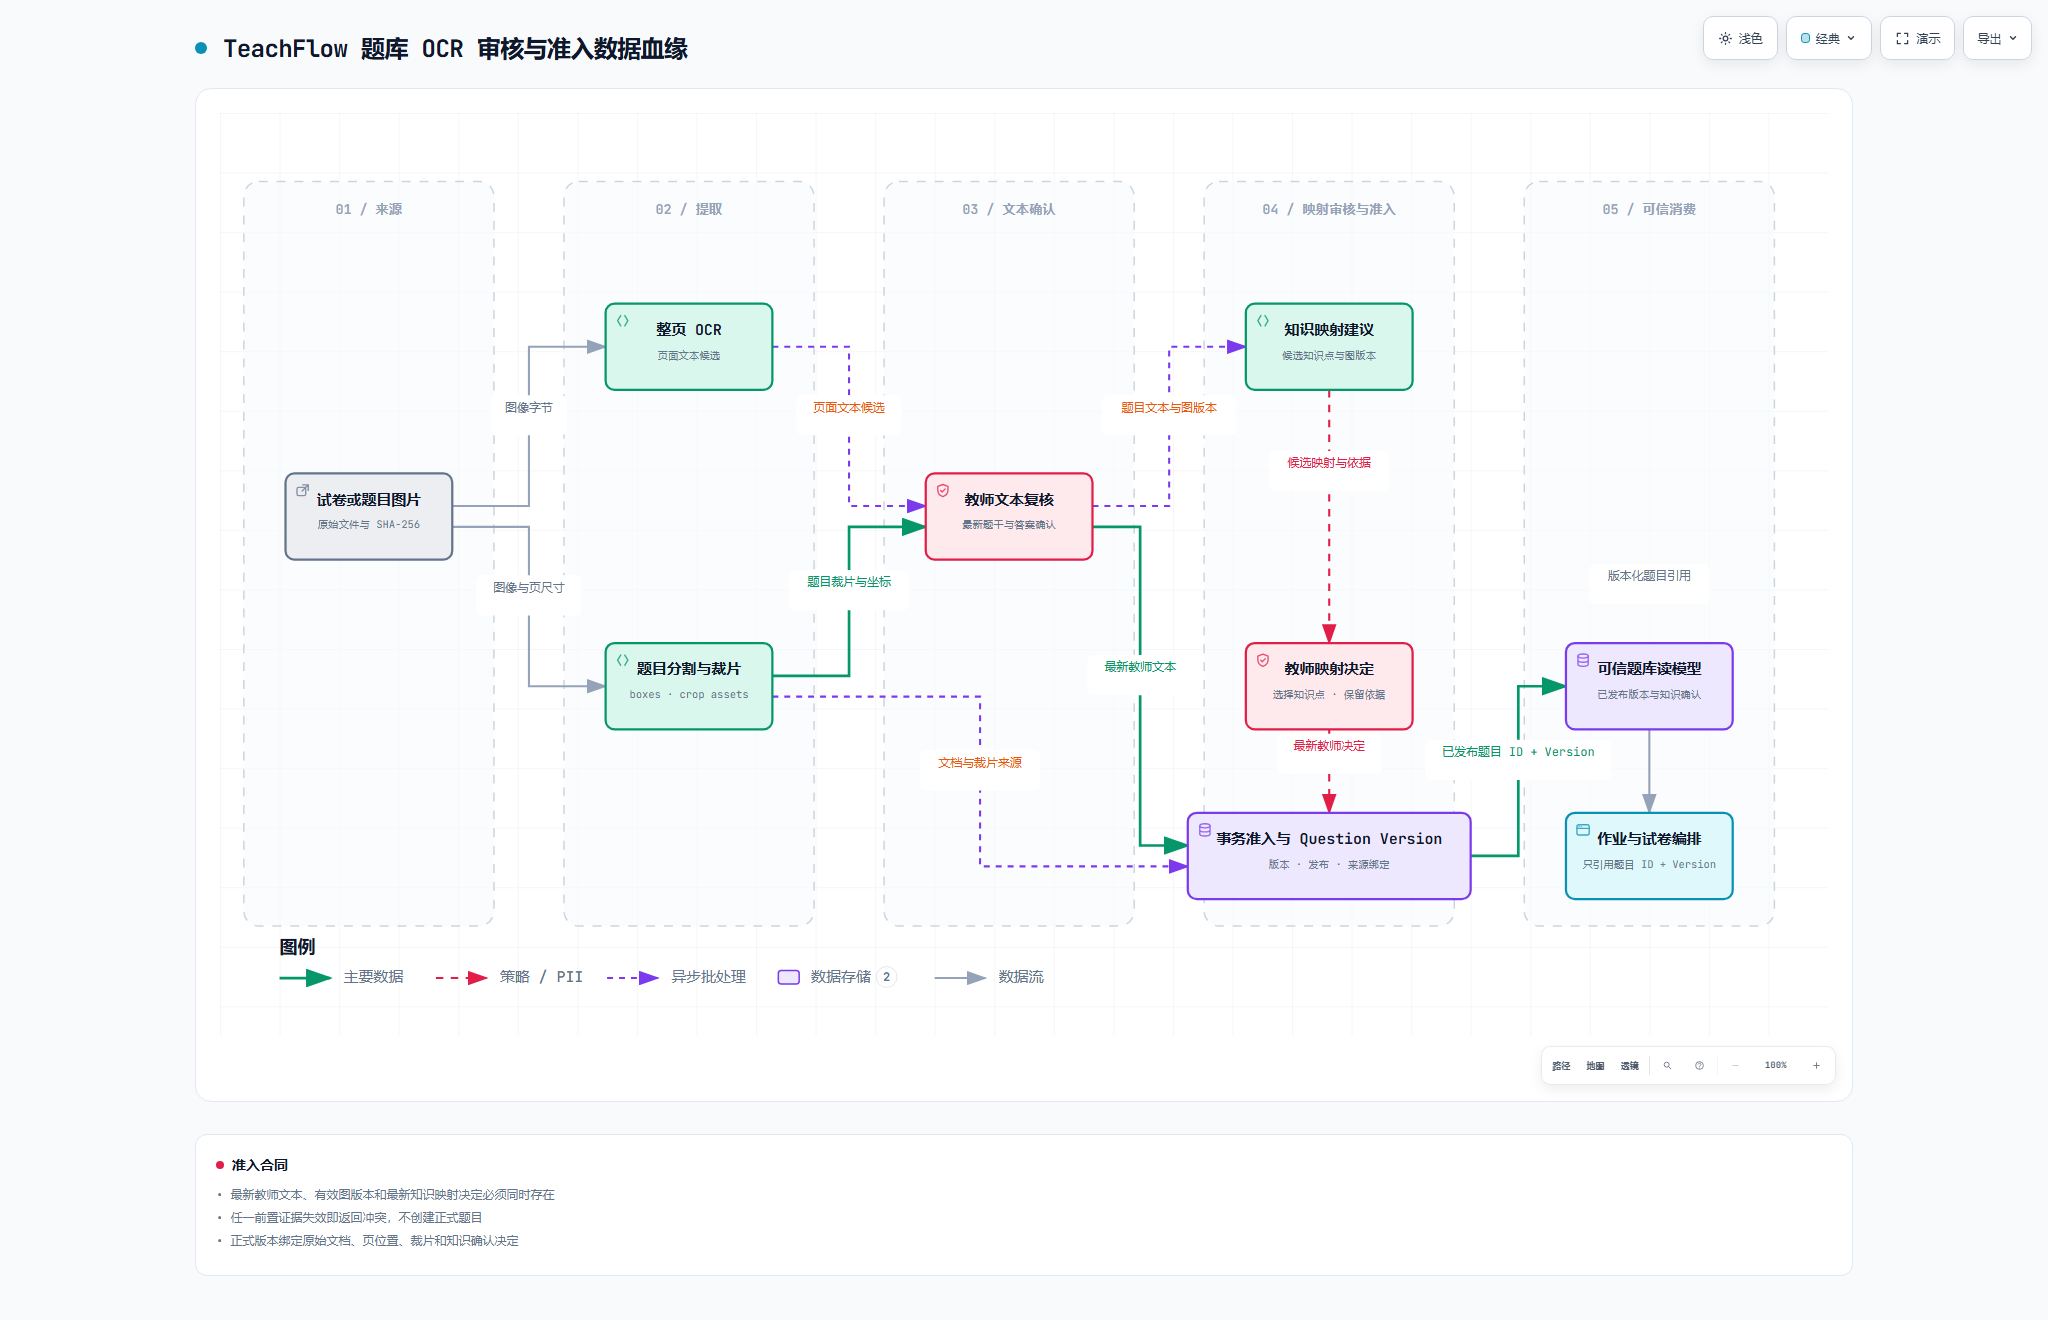
最初看起来最直接的流程是:把整页试卷交给视觉模型,让它一次完成 OCR、切题、知识点判断和题库入库。样本验证很快暴露了根因:整页识别错误会跨题传播,公式和栏布局会污染边界,昂贵模型调用发生在教师尚未决定是否加工之前,最后还说不清正式题目来自哪一块原图。
TeachFlow 因此把主链改成“先确定题目边界,再对单题做识别”。
原图是证据,不是临时输入
教师上传形成导入批次,原文件、页码和内容指纹先被保存。版面分析只产生候选框,不直接制造正式题目。教师可以移动、缩放、拆分或拒绝候选框;确认后的裁片拥有稳定来源,后续 OCR、知识点建议和发布都能回到它。
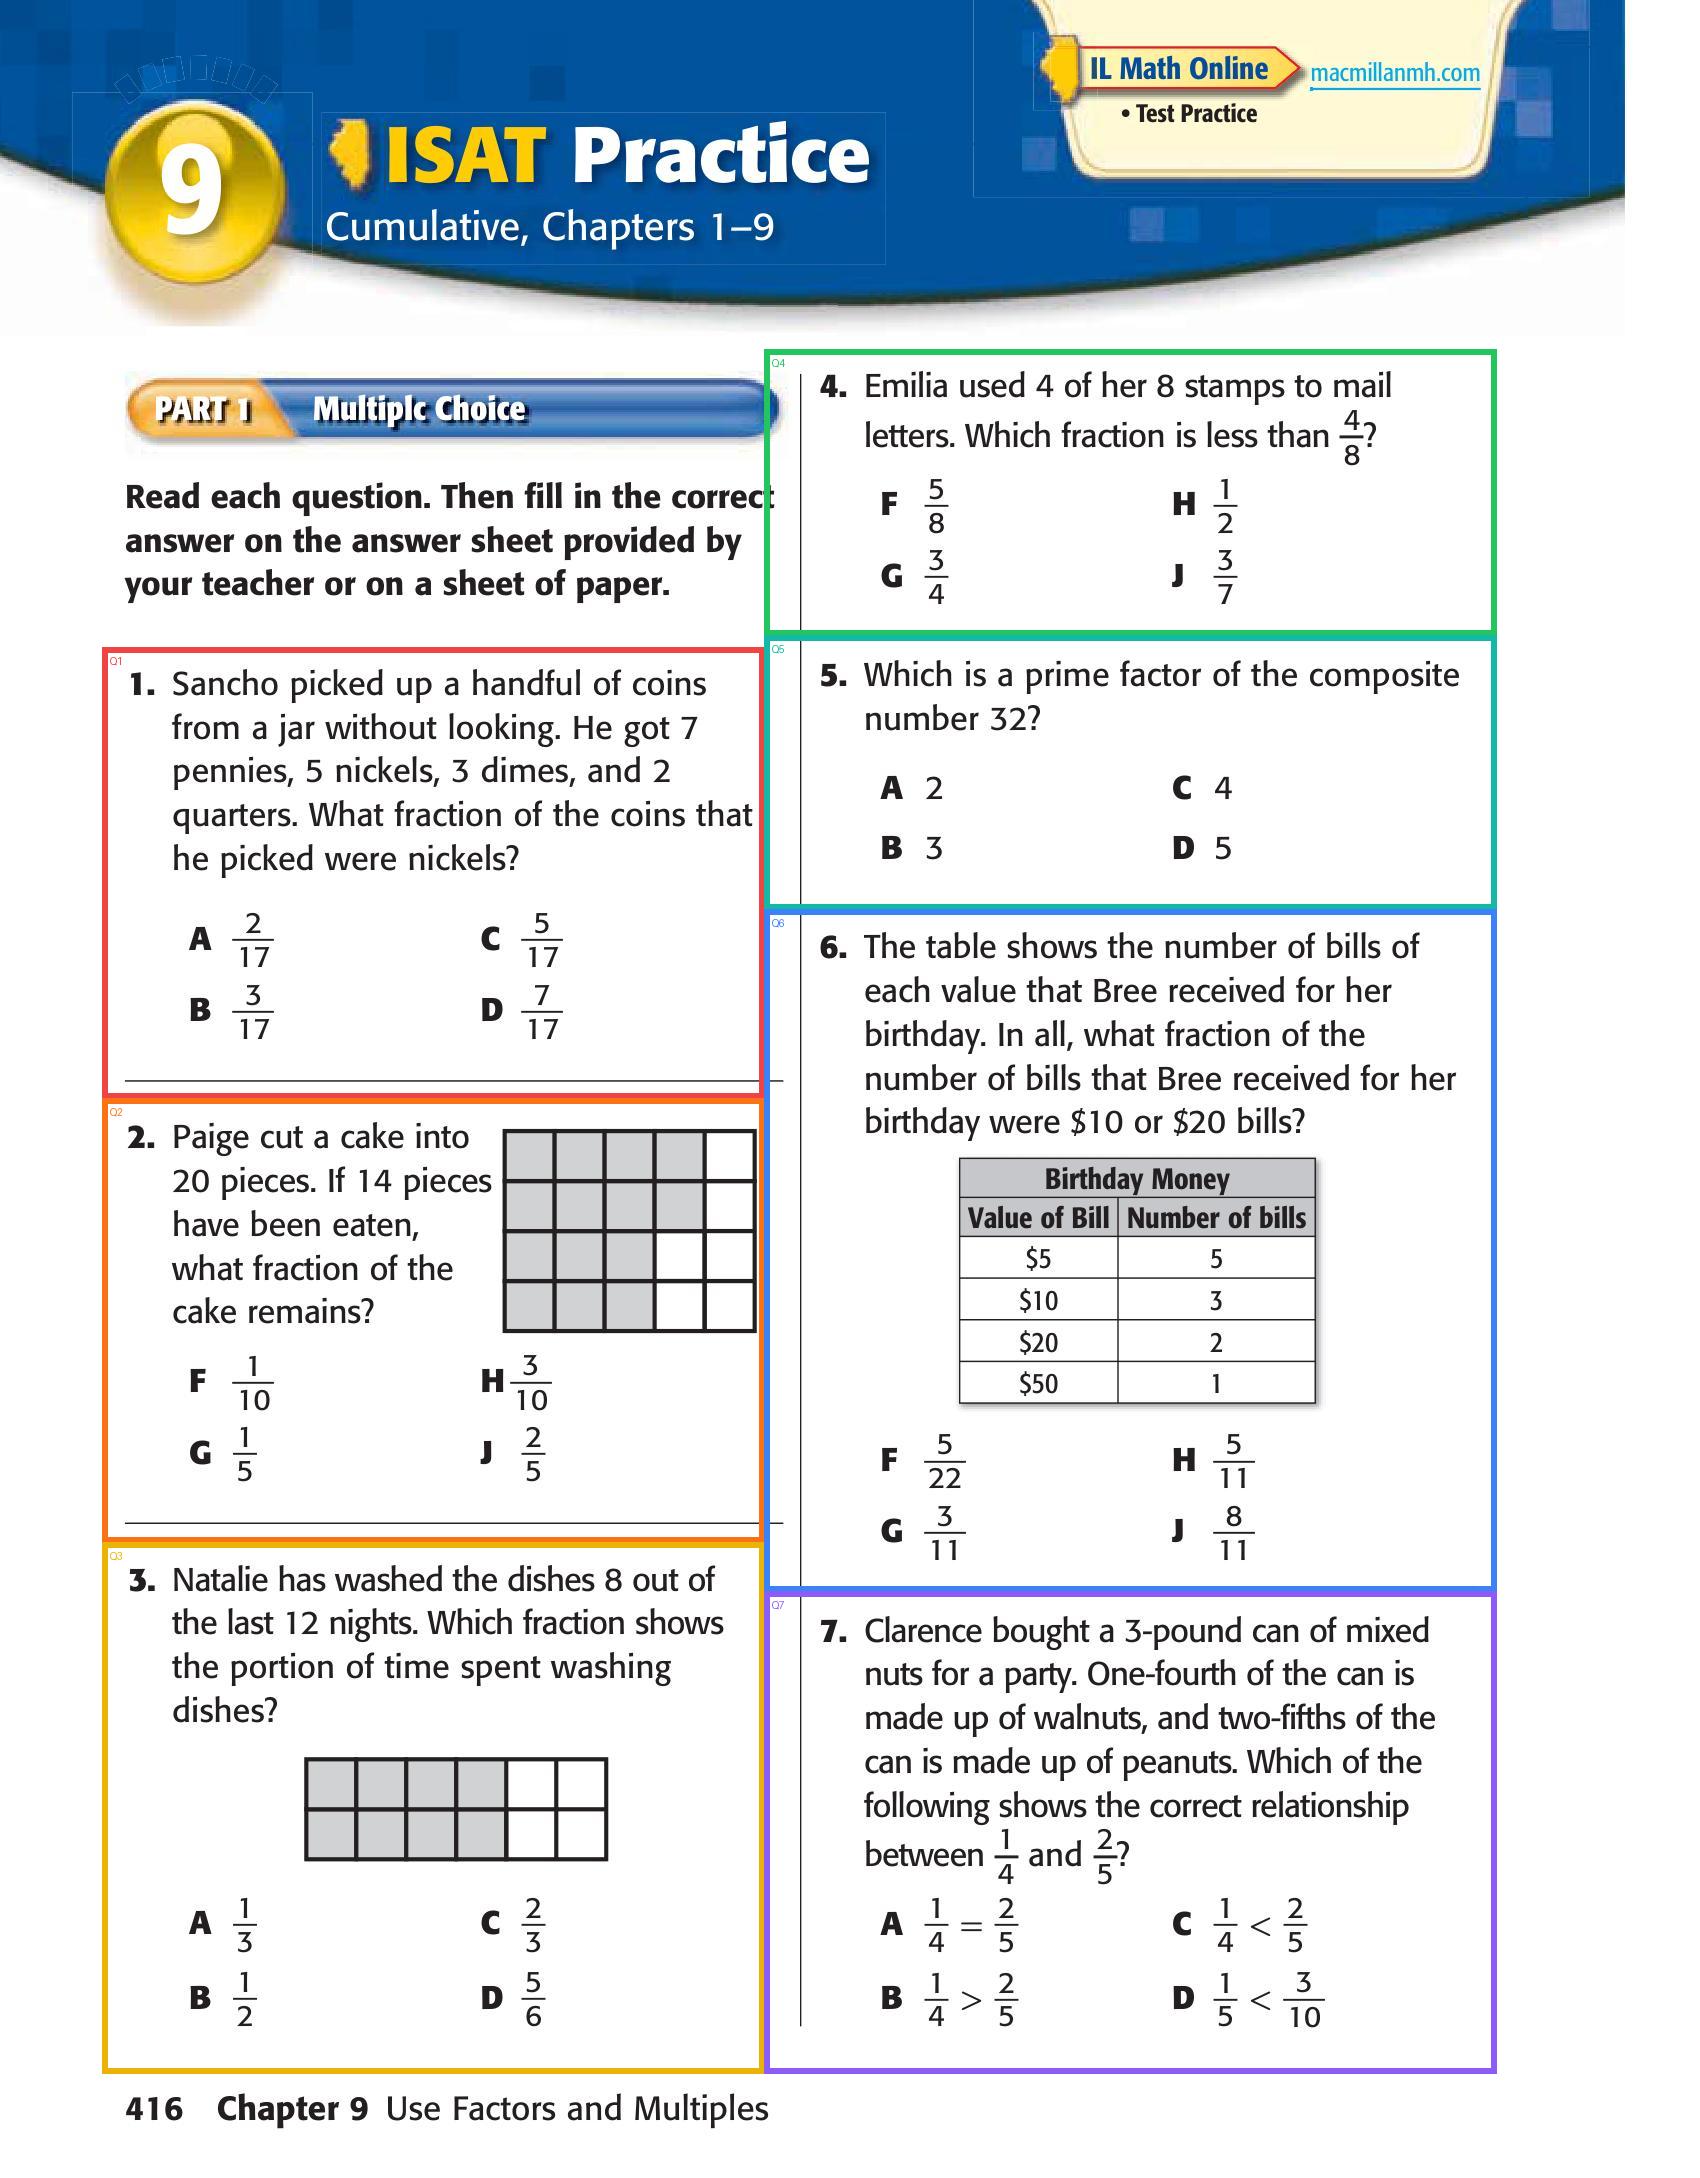
这让错误被限制在最早的可见层:边界错了先修框,不让错误文本继续进入题干、答案和知识点映射。
OCR 输出与人工修正分开保存
OCR 模型原文和教师修正不是同一字段反复覆盖。当前文本可以由最新修正派生,但原始模型输出仍然存在;重复点击已成功的来源不会再次调用 Provider。PDF 与 Office 文件在尚未提供可靠页面渲染时明确保留原件,不伪装成已识别。
知识点建议也允许返回 no-match。主动弃权比硬塞一个目录 ID 更重要,因为一旦错误映射进入正式题目,它会继续污染作业、评分和学情。
正式入库是一个原子门
只有确认裁片、有效题干、答案合同和教师确认的知识关系都满足要求,题目版本才进入正式题库。题目后续修改会产生新版本,并重新要求知识点确认;旧作业继续指向旧版本。
错误为什么会沿流水线放大
设想一张双栏试卷,版面模型把左栏第 3 题和右栏第 8 题框成同一块。如果系统先对整页 OCR,再让模型拆题,错误文本可能已经混入题干、答案和解析;知识点建议又会基于这段错误文本给出看似合理的目录 ID。到教师发现问题时,至少三层派生数据都需要回滚。
先切题把错误压缩在候选框层:教师只需修正坐标,后面的 OCR 与建议重新基于同一来源裁片运行。裁片内容指纹还能区分“相同来源的安全重试”和“边界变化后的新识别”,避免重复调用模型或错误复用旧结果。这不是单纯提高 OCR 准确率,而是改变错误成本和可追溯性。
设计取舍:人工确认会不会让 AI 失去价值
人工门禁不等于每一步从零操作。版面分析负责提出候选,OCR 负责转写,映射器负责排序候选知识点;教师只在高风险转折处确认边界、文本和正式关系。产品目标是把人工注意力放在“是否进入权威题库”,而不是让教师手工完成整条流水线。
评价 OCR 准确率时,需要注意当前没有代表性复杂试卷集的本轮统计。单题候选图、数据血缘图和 question-bank.ts 的追加记录合同只能证明现有处理路径,不能由单个样本推导模型泛化能力。
当前边界
现有图表、评估裁片、源码和历史回归记录支持这条设计,但本轮没有重新调用 OCR 模型或执行完整题库浏览器流程,因此状态为 partial。识别准确率不能从单页样本外推;复杂多栏、跨页题、手写公式和生产模型成本仍需代表性数据集评估。
结论
题库流水线的核心不是 OCR 多快,而是错误在哪里被看见、被拒绝和被纠正。先切题、再识别、最后人工准入,让 AI 成为候选生成器,而不是题库事实的匿名写入者。