返回 ResolveAI 项目总览 · 交互图:REPLAYABLE · EVALUATION · ASSETS
很多 Agent 项目会保存一段“效果不错”的对话,然后把它叫作测试样例。问题是:下次谁来判断它仍然正确?只保留用户消息,没有业务初始状态;只保留模型答案,没有期望业务结果;只保留一个总分,没有禁止行为和事实断言;只记得“当时通过”,却不知道今天重新运行时到底用了哪份资产。
ResolveAI 是我的个人实践项目。我希望它回答的不是“能否多存几条对话”,而是一个更严格的问题:怎样把一次运行证据转成可以版本化、选择、批量重跑和重新判分的评测资产,同时不伪装成确定性的历史环境复刻?
这篇文章聚焦五个对象:Evaluation Contract、Evaluation Case、Evaluation Batch、Run 和 Regression Dataset。它们互相关联,但不能互相代替。
五个对象分别回答什么问题
| 对象 | 主要问题 | 是否是历史运行结果 |
|---|---|---|
| Evaluation Contract | 这个场景的业务成功、必要状态、回复模板和禁止行为是什么? | 否,它是场景级判定合同 |
| Evaluation Case | 对某一组固定输入,应该按什么业务真值判定? | 否,它是可复用的输入与期望快照 |
| Evaluation Batch | 这次选了哪些 Case 或哪个 Dataset,用什么运行版本执行? | 否,它是一次调度与归组 |
| Run | 这次实际输入、配置、Provider 证据、Tool 轨迹和业务结果是什么? | 是,它是一次不可替代的执行证据 |
| Regression Dataset | 哪些人工审阅过的失败样例已经组成一个可发布、可追溯的回归集版本? | 否,它是版本化样例集合 |
这个拆分首先避免一种常见混淆:旧 Run 证明“当时发生过什么”,Evaluation Case 规定“以后拿什么重新运行、按什么重新判分”。
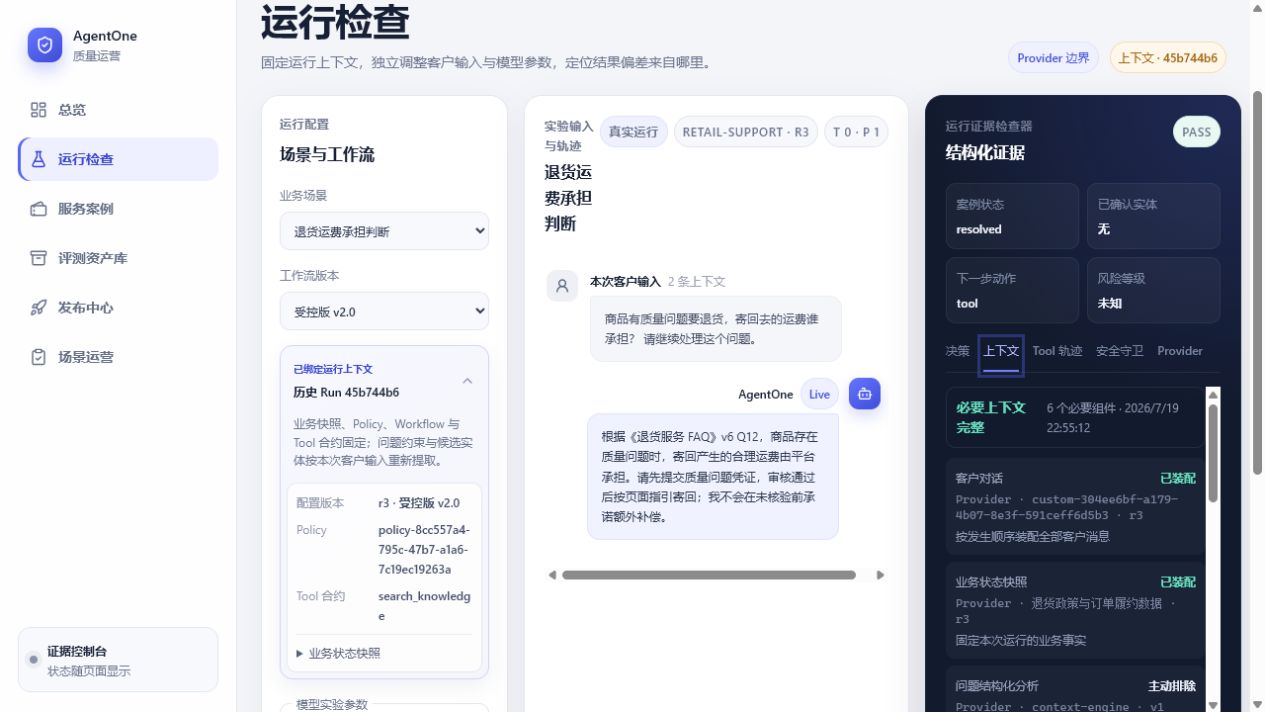
真实产品截图:左侧锁定历史 Run 的配置修订、Policy、Workflow、Tool 合同与业务状态,中间保留当次对话,右侧保留结构化证据。它是 Case 的来源证据之一,但不是 Case 本身。
一个 Case 至少要固定两类快照
EvaluationCase 不是一条字符串。当前模型同时保存:
inputSnapshot:消息和初始业务状态,也可以保留上下文 Run 等输入关联;expectationSnapshot:业务目标、期望业务结果、期望决策、禁止行为,以及可选的 Fact Oracle;configurationRevision:创建资产时关联的场景配置修订;source与sourceRunId:它来自平台模板、人工输入、Run,还是 AI 草案;coverageLayers与admissionReason:它覆盖哪些风险层,为什么值得进入资产库;version、supersedesId、status:它属于哪一代,替代了谁,当前是否仍活跃。
只有输入而没有期望,得到的是回放脚本,不是评测资产。只有期望而没有输入,得到的是抽象规则,不能独立重跑。只有总分而没有业务目标、决策和禁止行为,失败时也很难回答“错在何处”。
对于事实抽取类 Case,项目还允许挂接 fact-extraction-oracle-v1:期望意图、必须出现的事实 Token、禁止出现的事实 Token、必须识别的缺失信息、是否要求否定理解,以及审阅人标签和时间。它让“模型大致说对了”变成可反驳的结构化断言。
Case 从哪里来,为什么来源要保留
ResolveAI 当前接受四类来源。
平台模板提供只读基线,适合稳定演示和最低能力检查。人工输入允许把新问法、业务目标、禁止行为和入库理由直接建立为客户资产。一次已完成 Run 可以被人工沉淀为 Case,系统会复制其输入快照、配置修订和场景真值,并用 sourceRunId 保留来源。AI 也可以提出草案,但它仍只是候选来源,不等于人工已经接受,更不能越过人工审阅直接进入回归集。
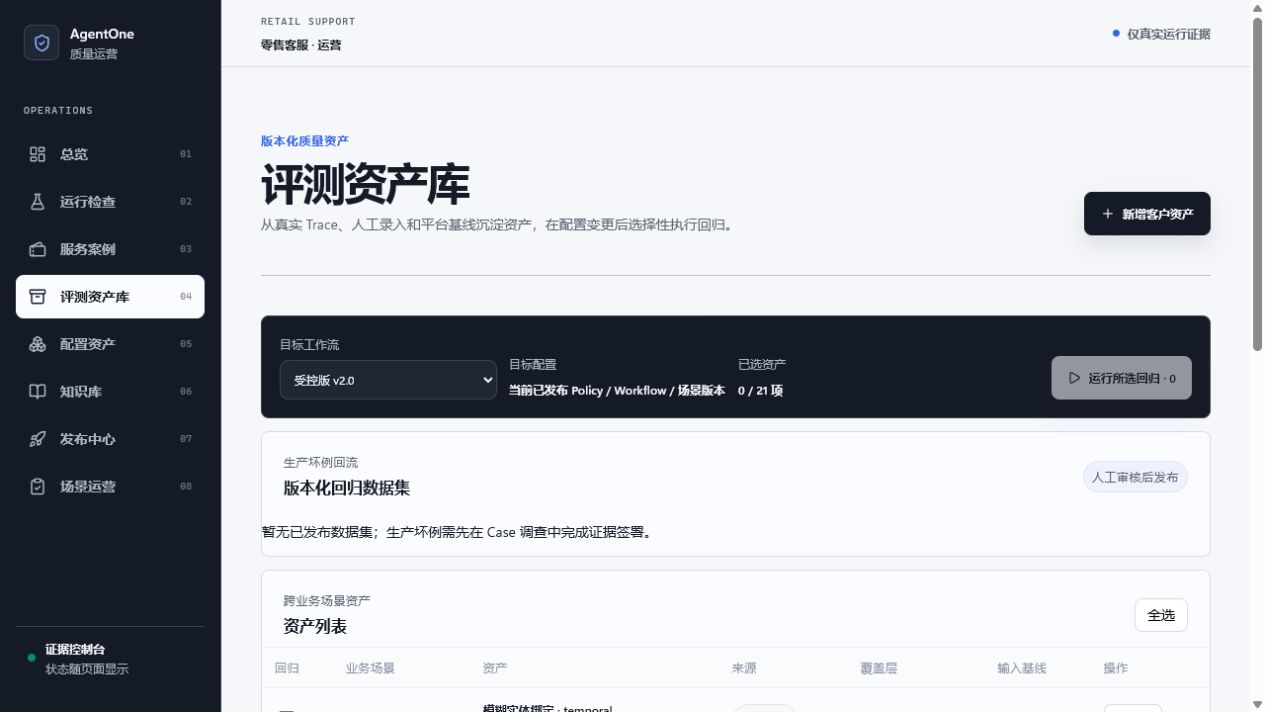
真实产品截图:目标工作流、目标配置、已选资产、版本化回归数据集和资产列表被放在同一页面,但保持独立状态。截图中的“暂无已发布数据集”也说明 Case 存在不等于回归集已经发布。
从 Run 保存 Case 时,Store 先按 sourceRunId 查重;同一 Run 再次保存会返回既有 Case,而不是悄悄复制一份。人工新建 Case 时,API 也会检测规范化后的重复消息。这样做不是为了追求绝对去重,而是避免同一证据因为空格或重复点击被误算成多份覆盖。
修改 Case 不是覆盖旧真值
客户管理的 Case 可以修订,但修订不是原地修改。
服务先确认当前资产仍为 active,平台模板则保持只读。合法修订会把旧 Case 追加为 archived,再生成新的 evaluationCaseId:版本号加一,supersedesId 指向旧 ID,输入消息、业务目标、期望结果、禁止行为和 Fact Oracle 进入新快照。
这条规则解决了一个很实际的问题:如果今天把“期望退款状态”改成了另一个答案,旧 Run 的失败究竟是模型错了,还是评测标准后来变了?保留两代 Case 后,至少可以明确看到判定真值发生过版本迁移,而不是让历史结果被当前表单静默重写。
当前实现使用事件追加和本地 JSONL 恢复这些资产;它证明了版本与恢复合同能运行,但不等于数据库事务、多实例并发或企业级不可篡改审计已经完成。
Batch 才是一次重放的执行边界
选择 Case 以后,服务不会把旧 Run 的结果复制一遍。它会创建一个 EvaluationBatch,记录:
- 所选
evaluationCaseIds或datasetRef; - 涉及的场景与修订引用;
- 运行版本,例如 guarded;
- 请求、完成和失败数量;
- 队列、运行、完成、部分完成、失败等批次状态;
- 操作者、时间和可选幂等键。
后台逐项读取 Case 的 inputSnapshot,交给 Runtime 重新执行,再把 Case 的 expectationSnapshot 作为显式评测合同传入。相同幂等键重复提交会复用既有 Batch,不会重复创建一组运行。
Batch 的价值是把“选了哪些资产”和“实际生成了哪些新 Run”绑定在同一执行范围内。单个 Run 仍保存自己的输入哈希、配置、Provider 尝试、Tool 观察、业务结果与 EvaluationResult;Batch 只是把一组 Run 组织成可追踪的回归活动。
重新判分为什么不能静默回退
evaluateRun(run, contract) 会优先使用 Case 或 Dataset 传入的显式期望:期望结果码、必要状态、期望决策和禁止行为。它结合当前 Run 的上下文完整性、Prompt 完整性、Policy 遵循、Tool 执行、知识检索与引用、业务结果,输出逐项 checks、verdict 和 firstPointOfDivergence。
如果评测合同仍是草稿、必要状态为空、对应回复模板不存在,或者显式合同缺少业务目标,结论是 degraded,首个分歧点是 evaluation.contract。系统不会因为场景中恰好还有另一份默认答案,就把不完整的资产包装成可信通过。
这条边界很重要。重放的价值不在于“又调用了一次模型”,而在于用明确、可版本化的业务真值重新解释本次运行证据。
失败如何成为 Regression Dataset
不是每个失败都应该进入回归集。Provider 超时、脏数据、误报和一次性异常如果未经判断直接沉淀,会让回归集变成历史噪声仓库。
当前路径要求失败 Run 先进入 Investigation,再由人工提交不可重复覆盖的 Review。只有 disposition 为 regression_candidate 的已审阅失败,才会生成 RegressionCandidate,复制来源 Run 的输入、期望决策、期望结果和禁止行为,并记录 reviewedBy。
发布 Dataset 时,Store 只接受状态为 approved 的候选。新的 RegressionDataset 继承上一活跃版本的 Items,再追加本次候选;版本号加一,上一版本归档,候选改为 promoted。Dataset 保存 datasetId + version + items + createdFrom + createdBy,因此“回归集”不是一个随时会变化的查询结果,而是可以明确引用的集合版本。
回放某个 Dataset 版本时,API 按指定版本取出 Items,创建带 datasetRef 的新 Batch,并对每个 Item 使用其输入快照和判定真值生成新 Run。旧 Dataset 和旧 Run 都不会被覆盖。
可重放数据流,以及它没有固定什么
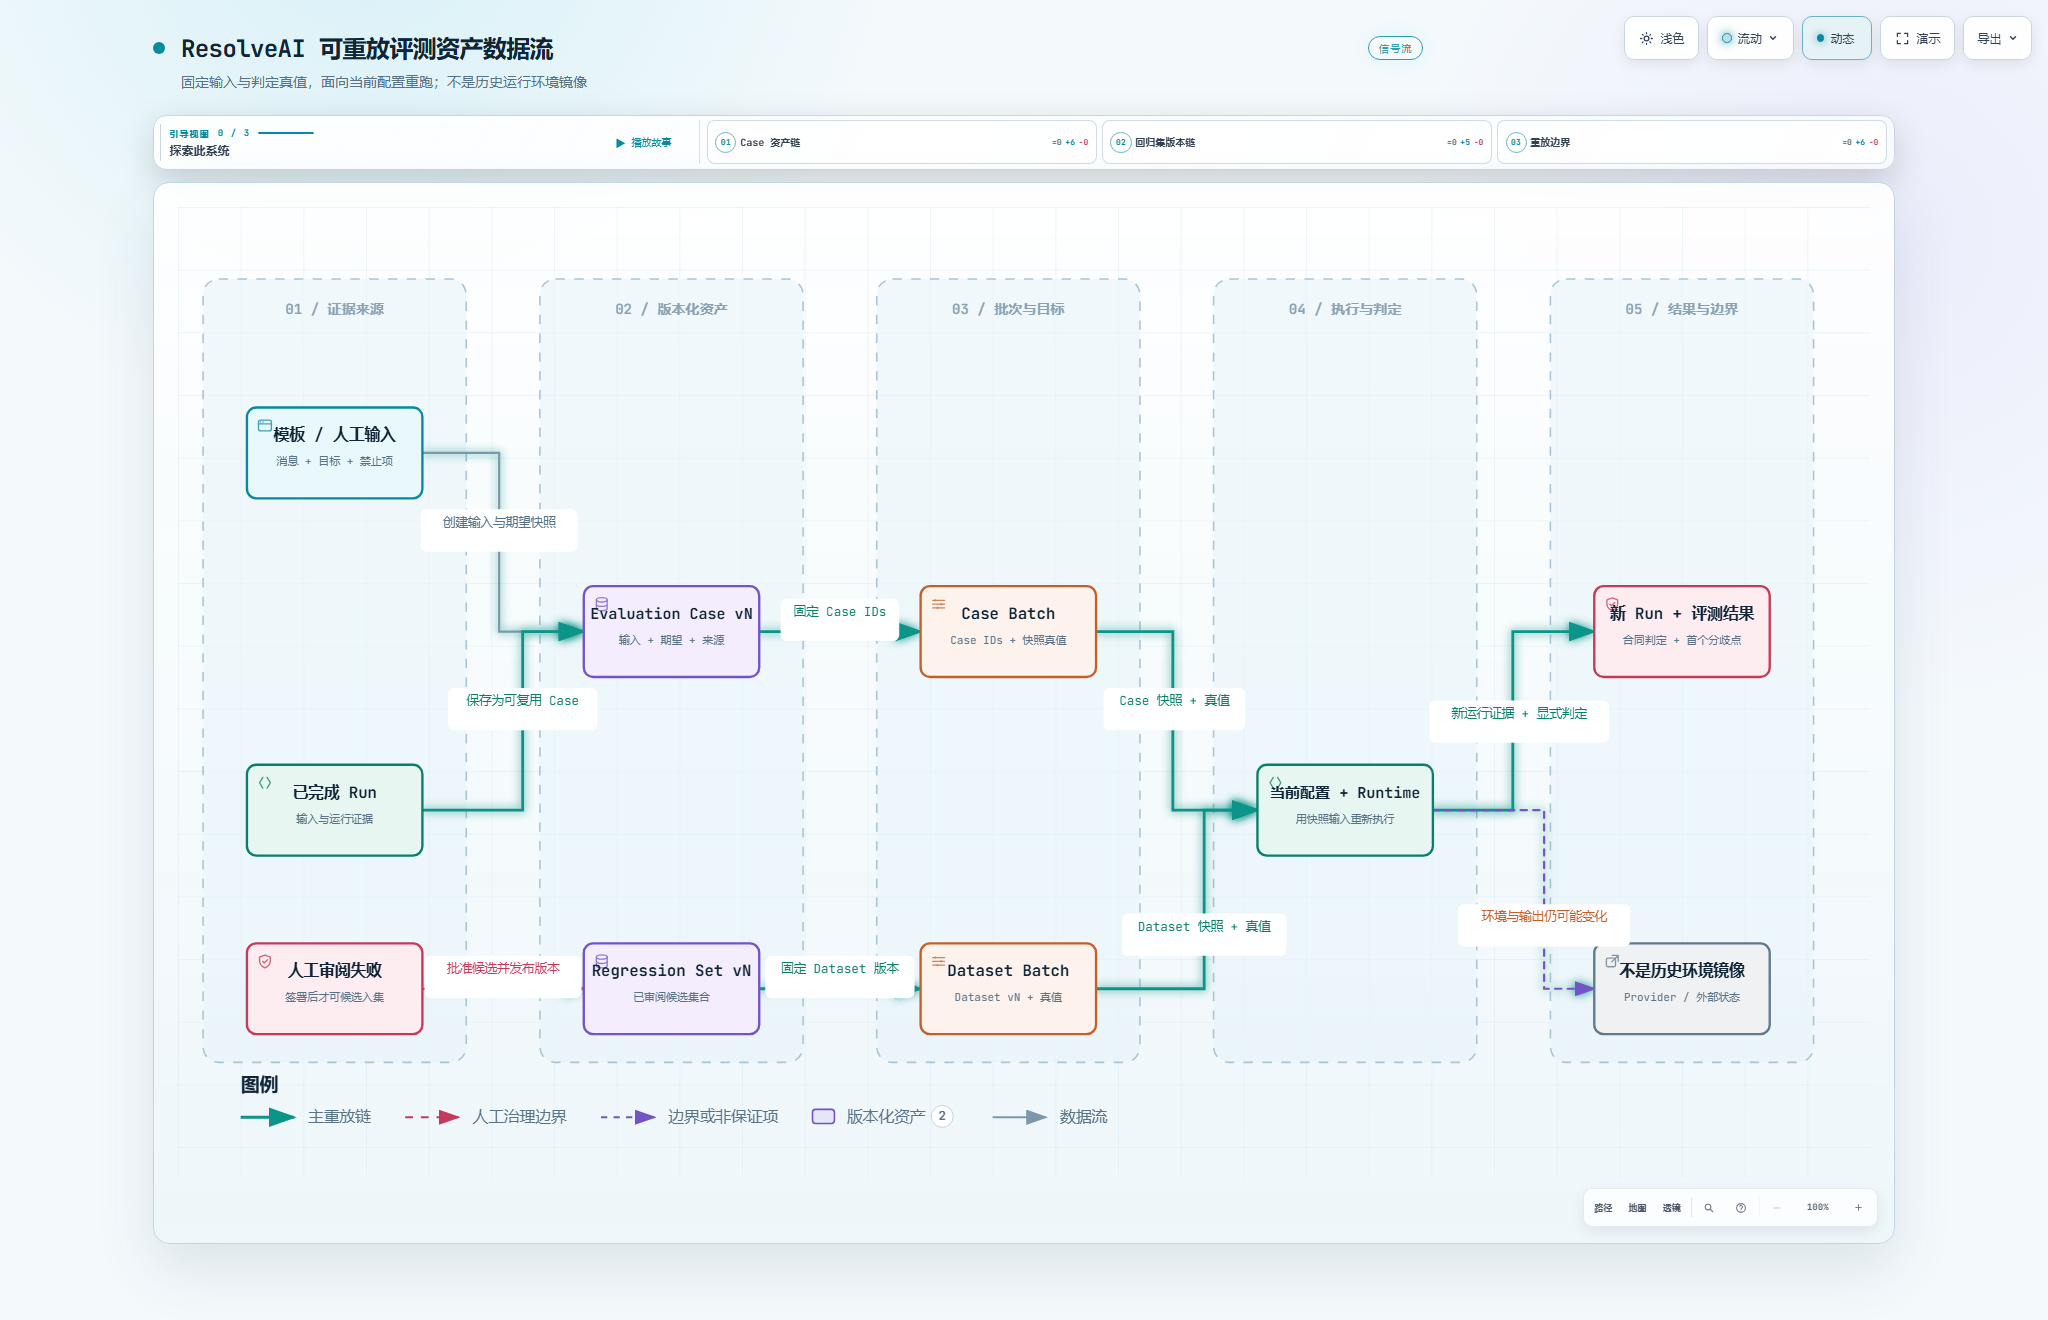
Archify 数据流图:上半链展示模板、人工输入和既有 Run 如何形成 Evaluation Case;下半链展示人工审阅失败如何形成版本化 Regression Dataset。两条链都通过 Batch 面向当前配置重新执行,并生成新的 Run 与评测结果。右下角明确保留非历史镜像边界。
交互版可以切换明暗主题,并分别聚焦 Case 资产链、回归集版本链和重放边界:/demos/resolve-ai/replayable-evaluation-assets/。
这里的重放使用历史输入执行新的 Run,而不是恢复全部历史运行环境。
Evaluation Case 会记录创建时的 configurationRevision,Batch 的 scenarioRefs 也会保存该引用;但是当前 Case 批次执行调用没有把这个修订作为 executeRun 的历史配置参数传入。Regression Dataset 回放同样先读取当前场景配置,并把当前修订写入 Batch。换句话说,当前重放固定的是输入与判定真值,运行目标是当前配置。
这正适合回答回归问题:“同一组已知输入与业务标准,在当前候选或当前配置上表现如何?”
它不适合被表述为:“完整恢复过去那一刻的运行环境,并保证产生相同输出。”当前资产没有封存 Provider 服务状态、模型服务端版本、采样随机性、外部 API 数据、时间依赖和所有基础设施条件。即便输入与真值完全相同,新的 Run 也可能得到不同轨迹;这恰恰是为什么系统要保存新证据并重新判分,而不是假设输出确定。
configurationRevision 已经提供了历史绑定线索,但执行链尚未真正消费它。因此我把这项能力表述为面向当前目标的可重放回归,而不是“历史环境复刻”。如果未来要支持严格历史重演,还需要显式解析历史配置、冻结外部依赖或提供可验证模拟器,并把 Provider 与模型版本纳入可追溯运行合同。
四个最小反例
第一,只保存用户消息。它可以重新发送,但没有初始业务状态、期望结果和禁止行为,不能证明运行正确。
第二,直接修改原 Case 的期望答案。如果旧版本没有归档,新旧 Run 会被同一个可变真值重新解释,历史结论失去可追溯性。
第三,把所有失败自动写入 Dataset。这样会把误报、Provider 故障和一次性异常当成产品回归事实,测试数量增加,信噪比反而下降。
第四,Case 记录了旧 configurationRevision,便声称系统恢复了历史环境。当前执行链没有传入该历史修订,Provider 和外部状态也未封存,这个说法会超过源码证据。
这四个反例分别验证了完整快照、不可变版本、人工入集和重放边界的必要性。
当前验证与证据边界
本轮执行了 4 个聚焦测试文件、126 项测试,覆盖显式评测合同、逐项检查与首个分歧点、Run/Batch/Case/Dataset 事件恢复、Case 创建/修订/归档、重复检测、幂等批次、人工审阅、不可变 Dataset 版本和 Dataset 回放 API;全部在当前工作树通过。
数据流图通过 Archify showcase 9/9 检查,0 个错误、0 个警告;完成 1440×900、1600×1000、1920×1080、2048×1320 的明亮主题 containment,以及 1440×900 和 2048×1320 的深色主题截图审阅。最终没有桌面溢出、线穿节点、关系交叉、共享走廊或标签遮挡;视觉修正 1 轮。
仍需保留五条边界:当前持久化主要是单进程内存与本地 JSONL;tenant 字段不等于企业租户隔离;操作者标签不等于认证身份;当前重放不固定完整历史配置与外部环境;现有样例和测试不能证明生产分布覆盖、长期稳定性或模型确定性。本文依赖未提交工作树,参考提交不能独立复现全部机制与证据。
再次检查一个旧问题时,先定位输入快照、判定真值与资产版本,再执行新 Run。这样可以比较当前目标的行为;若需要复刻历史结果,还要补齐历史依赖与运行环境。生产质量则需要真实业务分布上的持续验证。