返回 ResolveAI 项目总览 · 交互图:知识 · GROUNDING · 证据
RAG 演示最常见的成功画面是:用户提出问题,系统命中一个文档,回答末尾出现一个引用。可是真正进入客服运营后,这三个现象都不能单独证明答案可信。
命中的可能是未来版本或已经被替代的旧政策;回答可能引用了真实文档 ID,却说出了相反结论;检索 Tool 可能返回 success,但生成模型补充了证据之外的条件;自动 Judge 也可能因为词项相似,把否定关系、数字或时效错误判成安全。
ResolveAI 将知识处理拆成版本化知识资产、受控检索、Evidence Pack、结构化回答合同、确定性 Grounding、语义 Judge 和版本化验收。检索负责找材料,后续步骤检查材料是否有效、回答是否引用了材料,以及引用是否支持当前结论。
这篇文章只回答一个问题:检索已经命中以后,系统怎样证明回答真的受到当前有效知识支撑,而不是只给一段流畅文本贴上引用装饰?
知识首先是运营资产,不是 Prompt 附件
知识文档进入 ResolveAI 时,会保存 documentId、标题、版本、生效时间、章节、正文、标签、来源、Provider、就绪状态、文档类型、权威级别、受众、Owner 和创建人。
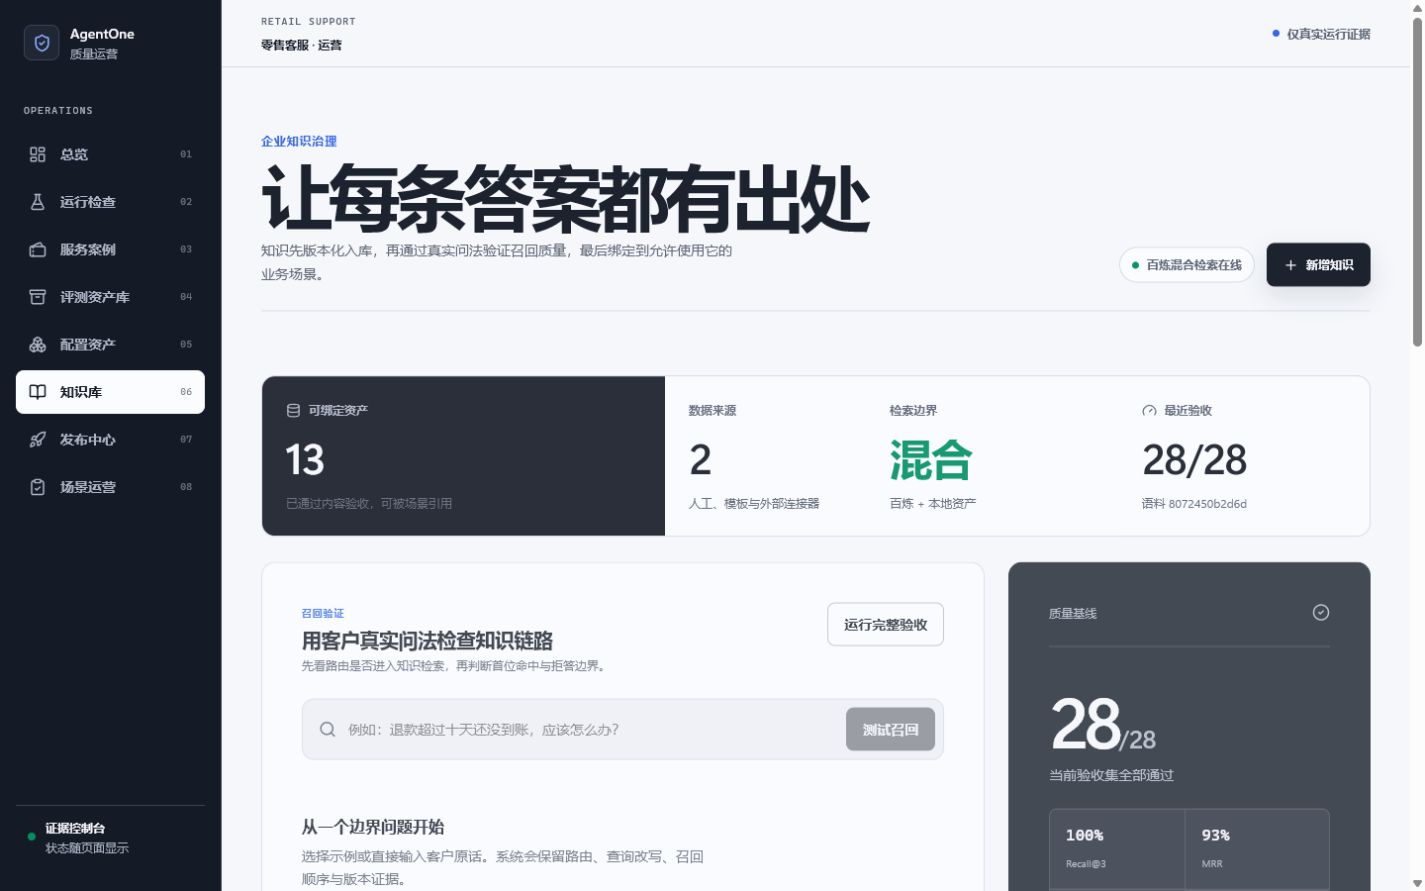
真实产品截图:知识工作区同时呈现可绑定版本、内容来源、检索边界、最近验收和客户原话检查入口。截图中的数值是既有本地验收快照,不代表当前生产知识库。
其中最重要的不是字段数量,而是三个约束。
第一,内容版本不会被“最新文件”静默覆盖。检索时使用场景的 asOf 过滤尚未生效的版本,再按同一标题选出当时最新的有效版本;Trace 会记录未来版本和被替代版本分别排除了多少条。
第二,ready 与 pending_validation 是不同状态。场景绑定知识资产时,服务端要求资产已经发布,并检查其中每个文档版本在当前知识库中仍然存在且为 ready;否则返回 knowledge_asset_contains_unready_documents,而不是让 Run 在缺失知识上继续工作。
第三,文档的受众和权威级别是知识治理的一部分。客户可见 FAQ、坐席内部 SOP 和运营内部内容不应该因为词项相似就进入同一公开回答。
这些约束仍是单机实践实现,不等于已经具备企业内容审批、细粒度 ACL 或跨系统版本事务。但它把“知识是什么、何时生效、谁负责、是否可被场景引用”从 Prompt 文本提升成了可检查的产品对象。
一次检索先判断该不该查
Query Router 在排序前先做领域路由。天气、创作和投资建议等问题会进入 not_knowledge,返回明确原因和空命中,而不是从客服知识库里勉强拼出一个答案。
对于应该进入知识检索的问题,Runtime 可以执行一组受控业务同义词改写。例如“水果”扩展为“生鲜”,“开封”扩展为“拆封”,“寄出来”扩展为“已发货”。这些改写是确定性表,不是一次不可重放的自由生成。
排序器随后记录:
- 原始 query、规范化 query 和实际应用的改写;
- 当前语料的
snapshotId; - 总版本数、有效版本数、当前文档数;
- 每个候选的 lexical match、tag match、分项分数和最终名次;
- Top K 与最终选中的文档 ID。
本地和远程检索结果也不会把两个不同量纲的 score 直接相加。当前混合逻辑先保留强本地命中,再接收超过阈值的远程结果,最后补充较弱本地命中,并按文档身份去重。它是明确的工程启发式,不是经过校准的统一相关性概率。
当前两个入口的远程失败语义并不完全相同:独立 /api/knowledge/search 在百炼调用失败时返回 502;Run 内部的知识路径则回退到本地 Evidence。后者保证远程故障不必让整次 Run 中断,但当前 knowledgeResult 没有把远程失败单独保存成完整降级来源,因此还不能声称这条 fallback 已经具备充分的可观测性。
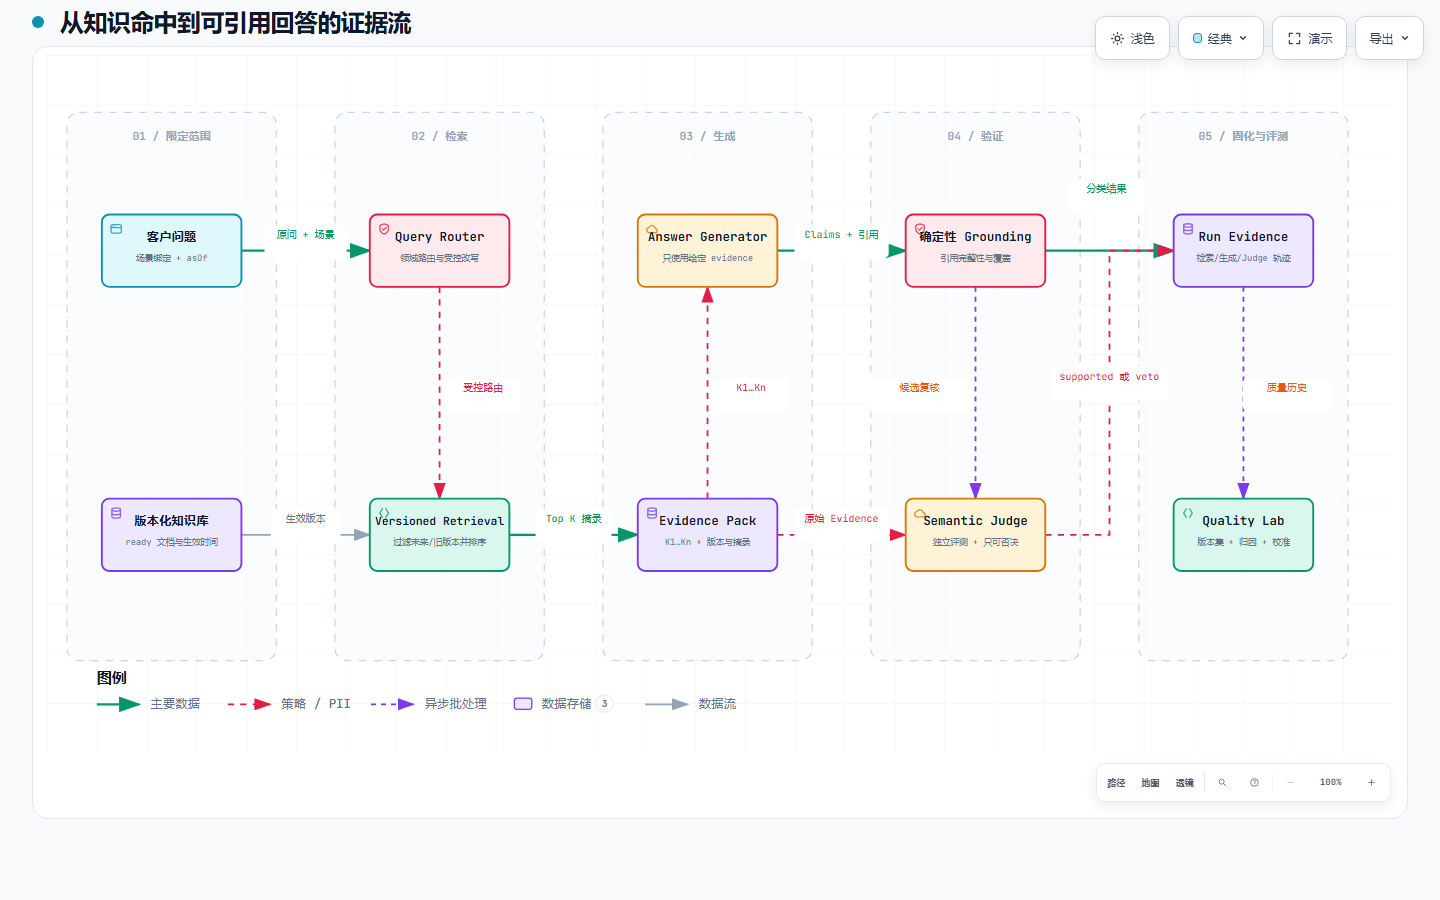
Archify 技术解释图:客户问题先限定场景和时间,再进入版本化检索;Evidence Pack 只允许生成器使用 K1…Kn,确定性检查先分类,Semantic Judge 只能对初步通过结果作复核或否决。
交互版数据流图可以切换明暗主题并追踪数据路径:/demos/resolve-ai/knowledge-grounding-evidence/。
Tool success 只证明“找到了”,不证明“说对了”
Run 中的 Tool 轨迹会保存实际 query、命中文档、版本、章节、摘录和执行状态。
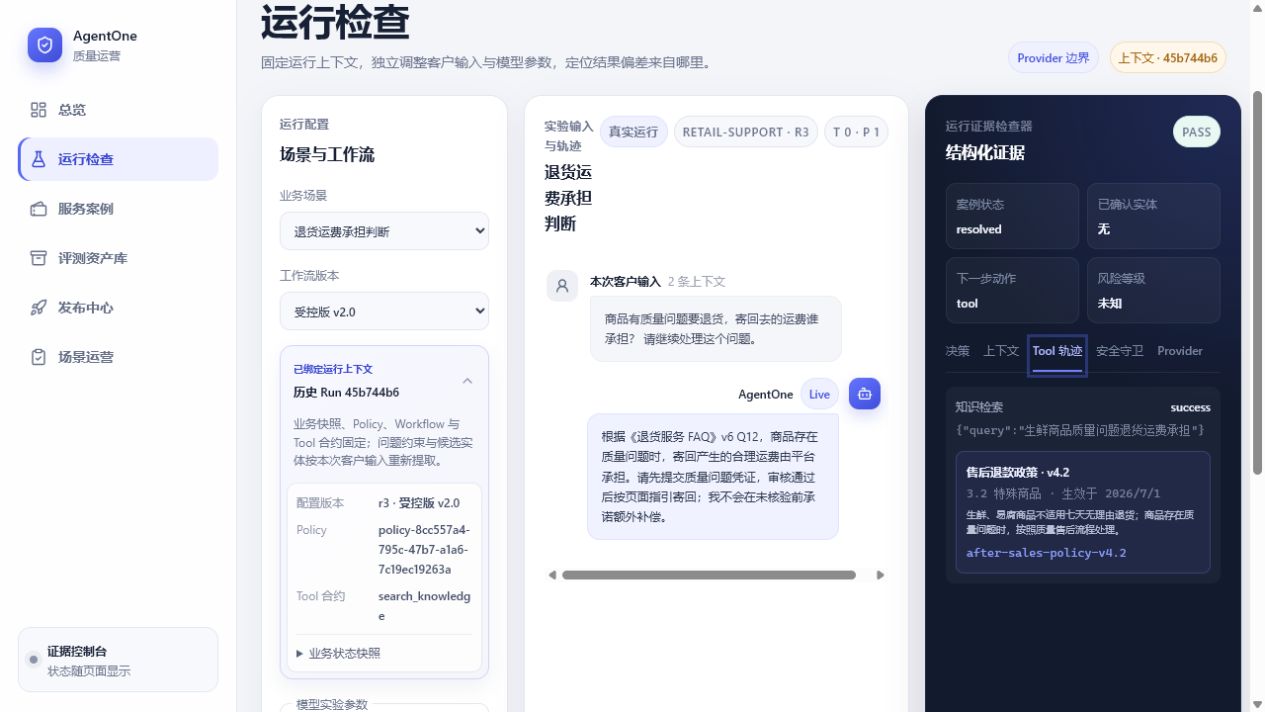
真实产品截图:知识检索返回售后政策 v4.2 的具体章节和摘录。这里的 success 只代表 Tool 调用完成。
这是必要证据,但还不充分。假设检索命中了“生鲜商品不适用七天无理由退货”,生成结果却写成“所有商品都可以无理由退货”,即使 Tool 成功,业务结果仍然应该失败。
因此当前 Runtime 把 knowledgeRetrieval 和 knowledgeGrounding 作为独立检查。测试中的最小反例是:检索成功并返回正确文档,但回答引用了不存在的 K9。最终 Run 保持 resolved: false,Outcome 是 knowledge_unsupported,评测首个分歧点是 citation.integrity。
这条反例比“系统支持引用”更重要,因为它证明引用不是展示层字符串,而是参与结果判定的合同。
Evidence Pack 限定生成器能看到什么
检索命中会被转换成 Evidence Pack。每条证据得到本次请求内稳定的 K1、K2 等 ID,同时保留文档 ID、标题、版本、生效时间、章节和摘录。
生成 Prompt 明确要求:只能使用给定 evidence;每个可验证事实必须拆成独立 claim,并引用至少一个 Evidence ID;证据不足时设置 abstained: true;输出必须符合 JSON 合同。
Expected Business Answer 不会放进生成请求。它只在后续评测中出现,避免模型直接复制评测真值制造假通过。请求还会生成 SHA-256 requestHash,并保存模型参数、响应耗时、Token 使用、完成原因和解析错误。
如果 Provider 返回普通文本、错误 JSON 或缺失合同,系统保存 degraded 和具体错误,而不是把“已经检索到文档”当成问题已经解决。
第一层:确定性 Grounding 检查
结构化回答先经过一组可重放检查,并按最早失败位置分类。
generation.contract 检查 Provider 输出是否符合结构;citation.integrity 检查所有引用 ID 是否真的来自本次 Evidence Pack;citation.coverage 要求每个可验证 claim 都有引用;answer.support 检查 claim 与所引摘录是否具备最低文本支持并保持否定关系;answer.business_alignment 再比较回答与场景 Expected Outcome 的关键业务条件。
结果不会被压缩成一个总分,而是分为:
grounded:当前确定性检查全部通过;unsupported:引用不存在或 claim 没有被证据支撑;insufficient_evidence:存在未覆盖的事实声明;misaligned:与业务合同不一致;abstained:系统明确承认证据不足;degraded:生成或响应合同失败。
这里也有明确边界:当前文本支持检查使用词项重合、否定关系和业务 term recall,是可解释的第一层门槛,不是完整的语义蕴含证明。因此项目增加了第二层 Judge,但没有让 Judge 取代确定性合同。
第二层:Semantic Judge 只能否决,不能批准一切
只有确定性检查已经得到 grounded 且存在结构化 answer 时,Runtime 才发起独立 Judge 请求。Judge 看到 query、answer、原始 evidence 和 Expected Business Contract,检查语义蕴含、否定关系、数字一致性、时间与版本、必要条件完整性和拒答是否恰当。
Judge 的运行模式是 advisory_veto:
contradicted、insufficient_evidence或over_abstained可以把初步grounded降为misaligned;supported只能增加一条评测证据;- Judge 不能把
unsupported、degraded等确定性失败升级成成功; - Judge 如果引用不存在的 Evidence ID,结果本身作废;
- 使用同一模型的独立请求和使用不同模型会分别记录
same_provider_separate_pass与separate_model。
这个边界刻意避免“让第二个模型给第一个模型盖章”。同时它也意味着当前实现不是 Judge 失败即阻断的 fail-closed 系统:Judge 请求失败或结果无效会留下错误和 judgeAlignment: null,但不会自动推翻已经通过的确定性结果。高风险生产场景是否需要强制独立模型、超时阻断或人工复核,是仍需根据风险等级决定的生产策略。
为了避免把 Judge 自信度当成准确率,项目另外维护 grounding-hard-negatives-v1:8 条覆盖否定翻转、数字 SLA、过期版本、遗漏必要条件、虚构引用、正确拒答和过度拒答的边界样本。校准报告保存混淆矩阵、precision、recall、F1、Provider 错误与 hardInvariantFalseSafe;只有硬性错误没有被误判为安全时,releaseGateReady 才可能为真。
这里的 8/8 测试使用受控 Fake Provider 验证校准合同和持久化,不是对某个真实 Judge 模型准确率的公开证明。
检索优化必须固定变量
知识工作区还提供查询改写归因。实验固定同一个客户问题、同一个 corpus snapshot、同一个 asOf 和同一个 Top K,只比较关闭改写与启用受控改写。
系统记录变化最早出现在 routing、query normalization、recall 还是 ranking,并在存在 Expected Document ID 时判断目标文档排名改善、下降或保持不变。如果没有业务真值,只能说结果发生变化,不能说更好。
这个实验只证明检索阶段的因果线索。即使目标文档从未召回变成 Top 1,也不能直接推导最终回答已经正确,因为生成与 Grounding 是后续独立环节。
28/28 证明了什么,也没有证明什么
当前版本化本地验收集 retail-knowledge-v1 包含 28 条用例,覆盖事实命中、问法变体、多轮线索、版本生效和 3 条 no-answer 边界。2026-09-02 的聚焦测试实际启动 API,运行并持久化该验收集,得到 28/28、Recall@3 为 1、No-answer Accuracy 为 1。
这些数字只证明:当前固定本地语料、lexical-router-v2、这 28 条版本化用例和测试环境下的检索合同通过。它们不证明开放域准确率,不代表所有客户问法,也不评估最终生成回答质量。
项目还保留了一份 2026-07-19 的历史外部知识验收:4 条零售问题全部未命中,结果为 blocked_for_retail_support。这份旧证据不能代表当前外部连接状态,但它说明了为什么“外部知识库已配置”不能自动等于“允许被业务场景采用”。
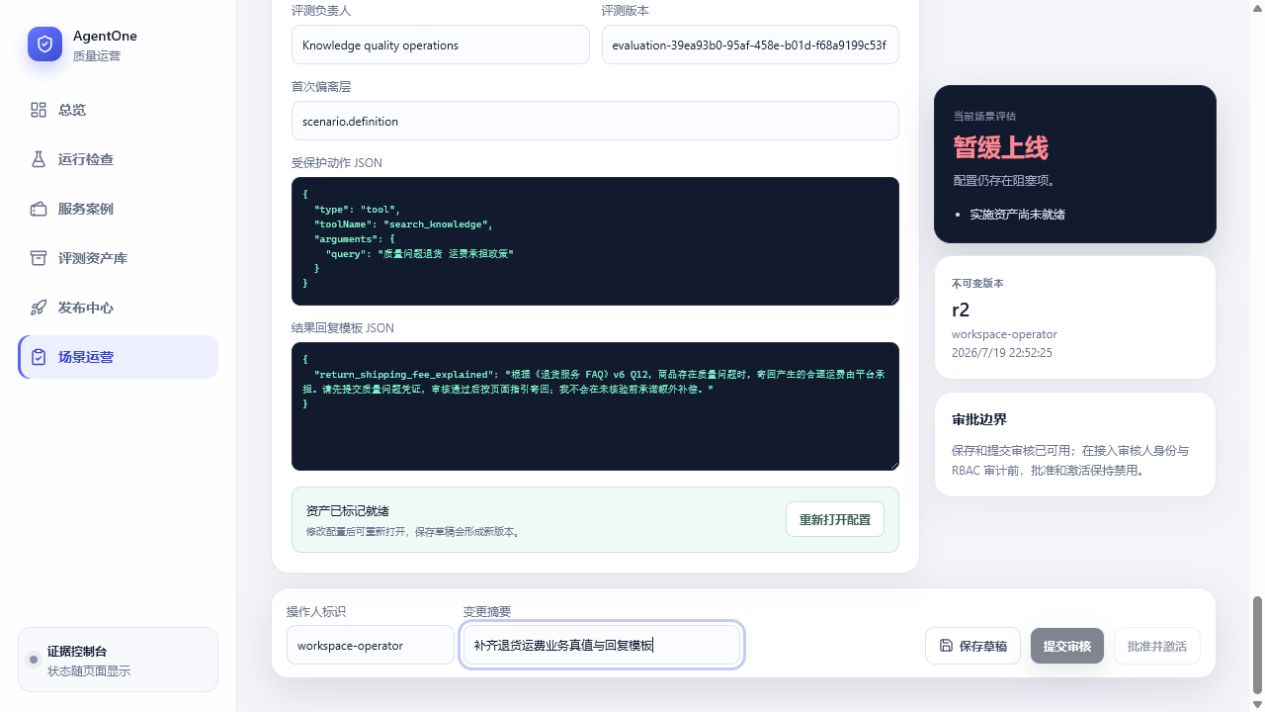
真实产品截图:场景配置在实施资产未就绪时保持暂缓状态。保存草稿、绑定资产和允许上线是三个不同状态。
当前边界
本文对应的聚焦验证覆盖 6 个测试文件、118 项测试,包括版本化检索归因、Grounded Answer 合同、Semantic Judge、百炼适配器、知识工作区和完整 API Runtime;全部在当前工作树通过。新数据流图通过 Archify showcase 9/9 检查,并完成 1440×900、1600×1000、1920×1080、2048×1320 明亮主题以及最小、最大尺寸深色主题的实际截图审阅。
仍需保留五条生产边界:当前知识存储是本地追加式实现;租户字段不等于完整的企业权限隔离;Run 中的远程失败回退尚缺完整降级来源记录;外部百炼适配器只完成了合同、错误和映射验证,当前没有生产可用性与质量证明;Judge、检索和 28 条本地集合都没有经过真实客户分布、长期漂移、容量和故障注入验证。
定位知识回答的问题时,可以依次检查版本、检索结果、引用和语义复核记录。Judge 的 supported 表示该层检查通过,后续业务批准仍由业务规则和授权流程决定。当前这条路径已在本地运行;生产数据上的质量与运行验证仍待完成。