返回 ResolveAI 项目总览 · 交互图:数据 · 治理 · RECOVERY
很多 Agent 项目做到“页面刷新后数据还在”,就会把能力概括成“已经持久化”。但真正进入故障场景时,问题会迅速变得更具体:一次写入失败后,内存是否仍会假装成功?某行 JSON 损坏时,系统是跳过它继续启动,还是明确阻断?备份复制了一组文件,能否证明它们没有被改过?恢复脚本返回成功,是否等于业务对象之间仍然一致?删除了一条隐私证据,旧备份里是否也随之消失?
ResolveAI 当前采用本地 JSONL 存储:写入成功后才更新内存投影,启动时从历史记录重建查询状态,畸形记录带文件与行号阻断读取。运维脚本逐行解析并计算 SHA-256,备份生成逐文件 Manifest,恢复默认进入独立目录;隐私证据在落盘前做确定性脱敏,删除后另存 record_absent 回执。多进程并发与生产灾备是这套存储方案尚未覆盖的要求。
这篇文章回答的不是“JSONL 好不好”,而是:在一个单机实践项目里,如何把“数据存在”“数据可读”“数据可恢复”“数据已删除”拆成不同、可反驳的主张?
先区分三条数据路径
ResolveAI 当前同时存在三条容易被混为一谈的数据路径。
第一条是运行与配置事实:Run、Review、Batch、Investigation、场景修订等记录被追加到 JSONL,服务重启后重新投影为页面查询状态。
第二条是冷备份与恢复:运维脚本读取全部 JSONL,生成记录数、字节数与 SHA-256;停服后复制文件并生成 Manifest;恢复时先验证备份文件,再写入独立目录,最后由操作者决定是否切换 Store 路径。
第三条是隐私治理:待验证载荷先经过规则型脱敏,只保存脱敏结果、短 Hash、命中字段路径和留存日期;删除时重写证据文件,并把删除原因与 record_absent 结果写到另一份回执文件。
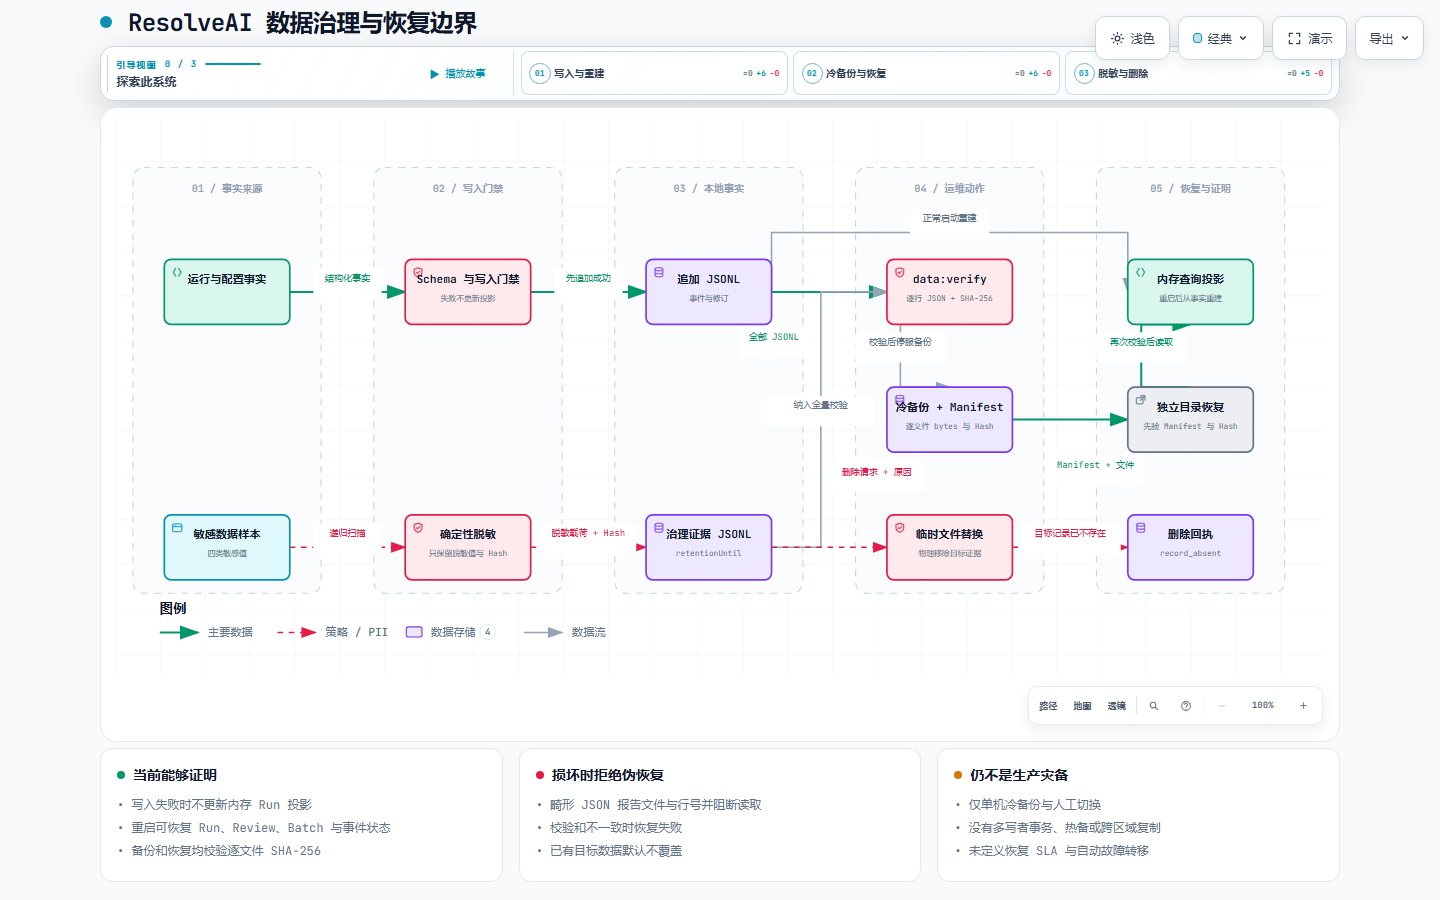
Archify 数据流图:绿色是主数据写入与重建,灰色是校验和冷恢复,红色是隐私脱敏与删除。三条路径共享本地文件边界,但证明对象不同。
交互版可以切换明暗主题,并分别聚焦“写入与重建”“冷备份与恢复”“脱敏与删除”:/demos/resolve-ai/data-governance-recovery/。
这张图最重要的信息不是节点数量,而是三条不能互相替代的结论:Run 能在重启后出现,不证明备份可用;备份 Hash 一致,不证明跨文件业务引用正确;证据文件中找不到目标记录,也不证明所有副本、日志和备份都完成了擦除。
为什么当前阶段选择追加式 JSONL
在这个项目的单机阶段,追加式 JSONL 有三个实际优势。
首先,它保留了人可以直接检查的历史记录。Run、评审、批次和调查不是只剩一份“最终状态”,而是可以从写入记录重建当前投影。对于当前阶段的个人实践项目,这种透明性比过早引入数据库基础设施更有价值:可以直接说明一条状态从哪里来,也能构造最小损坏样本验证失败行为。
其次,追加写入让历史兼容策略更明确。Run Store 同时识别旧版 Run、旧式 Review 记录和带 schemaVersion 的事件信封;场景配置读取旧记录时,会补齐缺失的 configurationVersion 并用当前 Schema 解析。这个过程只创建兼容投影,不在启动时回写旧文件。历史证据因此不会因为代码升级而被静默“清洗”成新格式。
最后,它控制了当前阶段的工程规模。项目真正需要验证的是 Agent 运行、评测、调查、发布和治理之间的合同,而不是先搭一套没有真实并发需求的数据库与消息队列。
但这个选择成立有前提:只面向单进程、单机、人工运维的实践环境。 一旦出现多实例写入、并发 Worker、正式租户隔离或恢复 SLA,JSONL 的简单性就会变成缺口,需要迁移到 PostgreSQL、事务约束、持久化队列和 Outbox。
最核心的不变量:落盘成功之前,不宣称写入成功
Run Store 创建一条 Run 时,会先对运行结果做敏感数据清洗,再生成 Evaluation 和可选 Investigation。若启用了文件持久化,它把 Run 与自动创建的 Investigation 组合成同一次 appendFileSync 调用;只有追加返回成功,才把 Run 放入内存列表、把 Investigation 放入查询 Map,并继续构造服务案例投影。
这解决了一个很具体的错误状态:磁盘写入失败,但当前进程的页面仍然能看到“成功保存”的 Run。聚焦测试会把文件路径指向不可写目标,确认 add 抛错后,Store 内存中也不存在该 Run。
场景配置采用同样顺序:先用 Zod 解析新修订,再追加 JSONL,最后把修订加入内存数组。保存还要求 expectedRevision 与当前修订一致,陈旧写入会返回 revision_conflict。
追加调用仍有两个故障窗口。
第一,把 Run 与 Investigation 拼进一次追加调用,只是降低应用层“两次写入导致孤儿调查”的风险;它没有 fsync、事务日志或崩溃恢复协议,不能声称一次系统崩溃下的字节写入原子性。
第二,Store 没有文件锁和多写者仲裁。两个进程同时追加、修订号竞争或跨文件更新时,没有数据库唯一约束替它守住不变量。
重启恢复的不是文件,而是查询投影
服务启动时,Run Store 逐行读取 JSONL。旧记录被升级为当前查询形态,事件信封根据 aggregateType 应用到 Release、Batch、Investigation、Evaluation Case 等 Map,最后形成页面需要的内存投影。测试重新创建 Store 后,能够恢复 Run、客户等待窗口、服务案例事件、Provider Attempt、Review、Regression Candidate、Batch、Investigation 和 Evaluation Case。
这意味着当前设计可以证明:在记录可解析且符合 Store 合同的前提下,服务重启不会把这些查询状态全部归零。
如果某一行是畸形 JSON,构造函数不会跳过该行继续启动,而是抛出 Failed to parse … at line N。这种“拒绝伪恢复”比悄悄丢一条记录更适合证据型系统,因为跳过损坏记录可能让后续聚合看起来完整,实际上已经缺少关键事件。
不同 Store 的读取边界并不完全相同。Data Governance Store 和 Scenario Config Store 会在 JSON 解析后继续做 Zod Schema 校验;通用 data:verify 脚本则只检查每行是不是 JSON,并输出文件级 Hash。后者是运维完整性检查,不是业务 Schema 验证器。
data:verify 能证明什么,不能证明什么
data:verify 会枚举数据目录中的全部 .jsonl 文件,拒绝内部空行,逐行执行 JSON.parse,然后输出每个文件的记录数、字节数和 SHA-256。它是只读操作,适合在备份前后比较物理内容。
它能够证明:
- 文件存在且可读取;
- 每一行都是合法 JSON;
- 当前文件的记录数、字节数和内容 Hash;
- 源目录与恢复目录是否得到相同的文件级指纹。
它不能证明:
- 每条记录符合对应领域 Schema;
- Run 引用的场景版本、知识文档或发布候选仍然存在;
- 多个 JSONL 之间没有悬空引用;
- 一组文件来自同一个逻辑时间点;
- Hash 有外部签名、可信时间戳或不可抵赖性。
因此,“所有 Hash 相同”只能推出恢复副本与备份内容一致,不能推出业务语义正确。
冷备份为什么必须先停服务
备份脚本复制全部 JSONL 到时间戳目录,再读取复制结果,记录文件名、字节数和 SHA-256,最后生成 manifest.json。脚本本身没有冻结写入者,也没有跨文件快照协议,所以操作手册要求备份前停止 API。
如果忽略停服要求,可能出现一个不容易被 Hash 发现的问题:runs.jsonl 在 10:00:01 被复制,scenario-configs.jsonl 在 10:00:03 被复制,中间刚好发生一次跨文件业务动作。两份文件各自 Hash 都完全正确,却不一定属于同一个业务时刻。
这也是为什么我把它称为“冷备份”,而不是“在线一致性快照”。
恢复默认进入独立目录
恢复脚本要求显式提供备份来源,并检查它位于配置的备份根目录内。随后它读取 Manifest,拒绝不支持或为空的清单,确认每个文件存在且 SHA-256 相符。目标默认是一个独立的 restored-data 目录;如果目标已经包含 JSONL,除非操作者显式增加 --overwrite,否则恢复会失败。
恢复成功只做了两件事:把经过校验的文件复制到目标目录,并输出 checksumsVerified: true。它不会自动替换服务正在使用的数据,不会启动 API,也不会偷偷迁移 Schema。正式切换前仍需停止服务、保留当前状态备份、对恢复目录再次执行校验,并逐项核对各 Store 的路径。
本次演练在 API 停止状态下,对 9 个 JSONL、460 条记录完成了源目录校验、Manifest 冷备份、独立目录恢复和恢复后复核;恢复目录的记录数、字节数与逐文件 SHA-256 均与源目录一致。
演练也暴露了一个尚未修复的 Windows 兼容缺口:同一目录如果一端使用 8.3 短路径、另一端使用完整路径,备份根目录的词法包含校验会把它们视为不同路径并拒绝恢复。统一使用同一种路径表示后正向恢复通过。这个问题不会造成静默覆盖,反而会安全拒绝操作,但它说明路径校验还没有做到文件系统身份级的规范化。
隐私证据为什么先脱敏再落盘
Run 写入和治理验证都复用确定性递归清洗逻辑。当前规则只覆盖四类明确值:形如 sk-… 的凭证、邮箱、中国大陆手机号和 18 位身份标识。清洗器递归遍历对象与数组,记录每个命中的字段路径;对名称以 hash 结尾且符合十六进制 Hash 形态的字段保留原值,避免把证据指纹误判成身份号码。
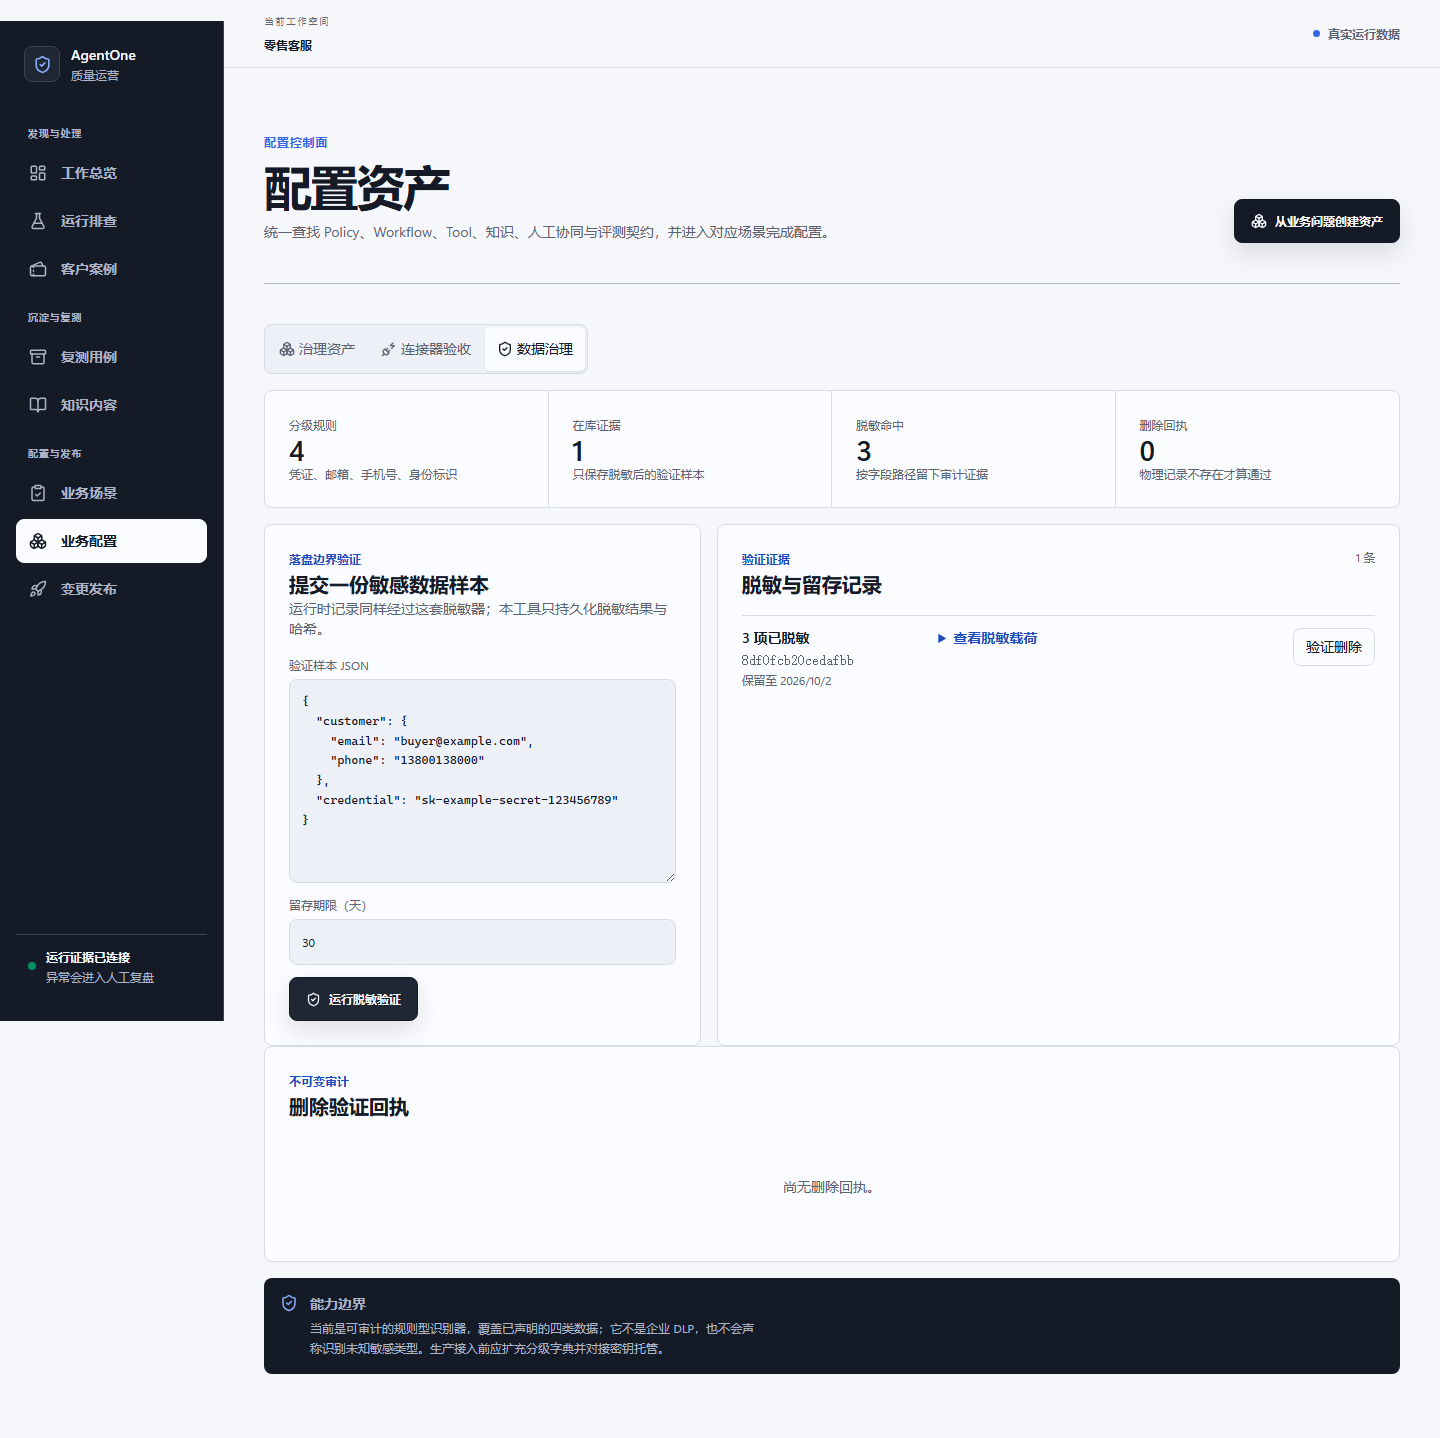
真实产品截图:验证样本包含邮箱、手机号和凭证,落盘证据只展示脱敏结果、命中数量、短 Hash 和留存日期。页面同时提供显式删除入口。
Governance Evidence 保存 tenantId、来源、脱敏载荷、脱敏 Hash、命中项、retentionUntil、创建时间和操作者标签。测试直接读取文件,确认原始邮箱不在持久化内容中,而 [REDACTED_EMAIL] 存在。
这里的能力边界同样明确:
- 四条正则规则不是企业 DLP,也不会识别所有秘密、地址、银行卡或自由文本中的隐私;
- 操作者标签不是认证身份;
tenantId是逻辑筛选字段,不是行级权限或多租户隔离;- 16 位截断 Hash 适合本地证据关联,不是签名、MAC 或防碰撞合规凭证;
retentionUntil当前只被记录,没有后台调度器在到期时自动删除。
record_absent 回执不等于“全局擦除”
删除治理证据时,Store 先从内存集合移除目标项,再把剩余记录写入 .tmp 文件并通过 rename 替换原文件。完成后,它在单独的回执 JSONL 中追加证据 ID、租户、删除时间、操作者、原因和 physicalVerification: record_absent。测试会重新创建 Store,确认目标证据不再出现,同时回执能够恢复。
这个实现比只把记录标成 deleted: true 更接近“当前证据文件中物理不存在”,但它仍有三条必须说明的边界。
第一,删除只覆盖 Governance Evidence Store。它不会扫描运行日志、截图、浏览器缓存、对象存储或历史冷备份。旧备份仍可能保存删除前的脱敏证据;如果要提出合规擦除主张,备份生命周期也必须纳入删除策略。
第二,当前实现先改变进程内数组,再写临时文件;如果临时写入或 rename 失败,当前进程的内存与磁盘可能短暂不一致。它还在替换证据文件后才追加回执,因此“删除成功但回执写入失败”仍是可能状态。这里不能声称跨文件事务。
第三,record_absent 是一次本地结果记录,不是外部审计签名,也不证明存储介质不可恢复。更准确的表述是:目标 ID 在当前治理证据文件的重写结果中不存在,并留下了一条独立回执线索。
四个最小反例
可以用四个反例检查这些边界是否真的被理解。
第一,data:verify 全部通过,但某条 Review 引用了不存在的 Run。JSON 和 Hash 都正确,业务关系仍然错误。
第二,Evidence 的 retentionUntil 已经过期,但没有人执行删除。字段存在不等于策略已执行。
第三,当前 privacy-evidence.jsonl 中已经没有目标记录,但昨天的冷备份仍有它。record_absent 不等于所有副本被擦除。
第四,单进程中的一次 append 返回成功,但两个进程同时写同一文件。追加式日志不等于数据库事务,也不等于 exactly-once。
这些反例把“看起来有治理字段”与“治理机制已经执行”分开,也把“恢复出相同字节”与“恢复出正确业务状态”分开。
什么时候必须升级存储架构
当前设计的停止条件很清楚。只要项目仍是单机实践、单进程写入、人工冷备份,并且目标是让证据可读、可重建、可演练,追加 JSONL 是合理折中。
出现以下任一要求时,就不应继续扩展这套文件方案:
- 多个 API 实例或 Worker 并发写入;
- 需要租户级认证、RBAC、行级隔离与审计;
- 一个业务动作必须跨多个聚合原子提交;
- 长任务需要租约、重试、死信和水平扩展;
- 需要在线备份、时间点恢复、自动故障转移或明确 RPO/RTO;
- 删除要求覆盖活动数据、备份、对象存储和审计留存策略。
目标架构不是简单把文件换成表:PostgreSQL 承担实体、状态、唯一约束与事务;对象存储承接大体积 Provider 输出和附件;Queue/Worker 执行异步 Batch;Outbox 解决数据库与事件发布的双写一致性;恢复和删除则需要独立的运维控制面与可审计策略。
当前验证与最终结论
聚焦回归执行了 4 个测试文件、126 项测试,覆盖 Run 与事件重启恢复、写入失败不保留内存 Run、畸形行定位、场景不可变修订与陈旧写入、旧数据兼容投影、四类递归脱敏、原始邮箱不落盘、物理删除和独立回执;全部在当前工作树通过。
数据流图通过 Archify showcase 9/9 检查,构图 0 error、0 warning;完成 1440×900、1600×1000、1920×1080、2048×1320 明亮主题,以及 1440×900、2048×1320 深色主题的 containment 和截图审阅,没有横向或纵向溢出、线穿节点、关系交叉、标签遮挡和导航重叠;经过 1 轮聚焦视觉修正。
这套证据足以说明:ResolveAI 当前单机实现能够把关键事实先持久化再更新查询投影;能从可解析历史记录重建多类运行状态;能执行逐文件校验、停服冷备份和隔离恢复;能在隐私证据落盘前做有限规则脱敏,并对当前证据文件执行显式删除与回执记录。
它不足以说明:生产数据库事务、多实例并发安全、热备、跨区域灾备、自动修复、恢复 SLA、企业 DLP、自动留存执行、全副本擦除、认证身份和真实多租户隔离已经完成。
这套存储方案便于检查记录与回放本地状态。若要支持多进程写入、跨文件一致性与生产恢复,需要围绕现有故障窗口重新选择事务、并发控制和恢复机制。