当 Agent 给出错误结果时,团队往往会很快拿到三样东西:一张失败截图、一段模型生成的原因说明、一次“修复后通过”的重跑。
它们都可能有用,却还不是一份完整的失败 Case。截图没有解释为什么业务上算错;原因说明可能只是合理猜测;原题重跑通过也可能只是针对当前输入的硬编码。
我在 ResolveAI 中把一条失败 Case 拆成三个必须分别回答的问题:
- 业务真值证据:凭什么说它错了?
- 运行归因证据:第一次在哪里偏离?
- 改进有效性证据:怎样证明不是只修当前 Case?
本文沿用博客名称 ResolveAI,讨论 AgentOne 个人复现版中的调查机制。文中页面与案例使用模拟业务资料。
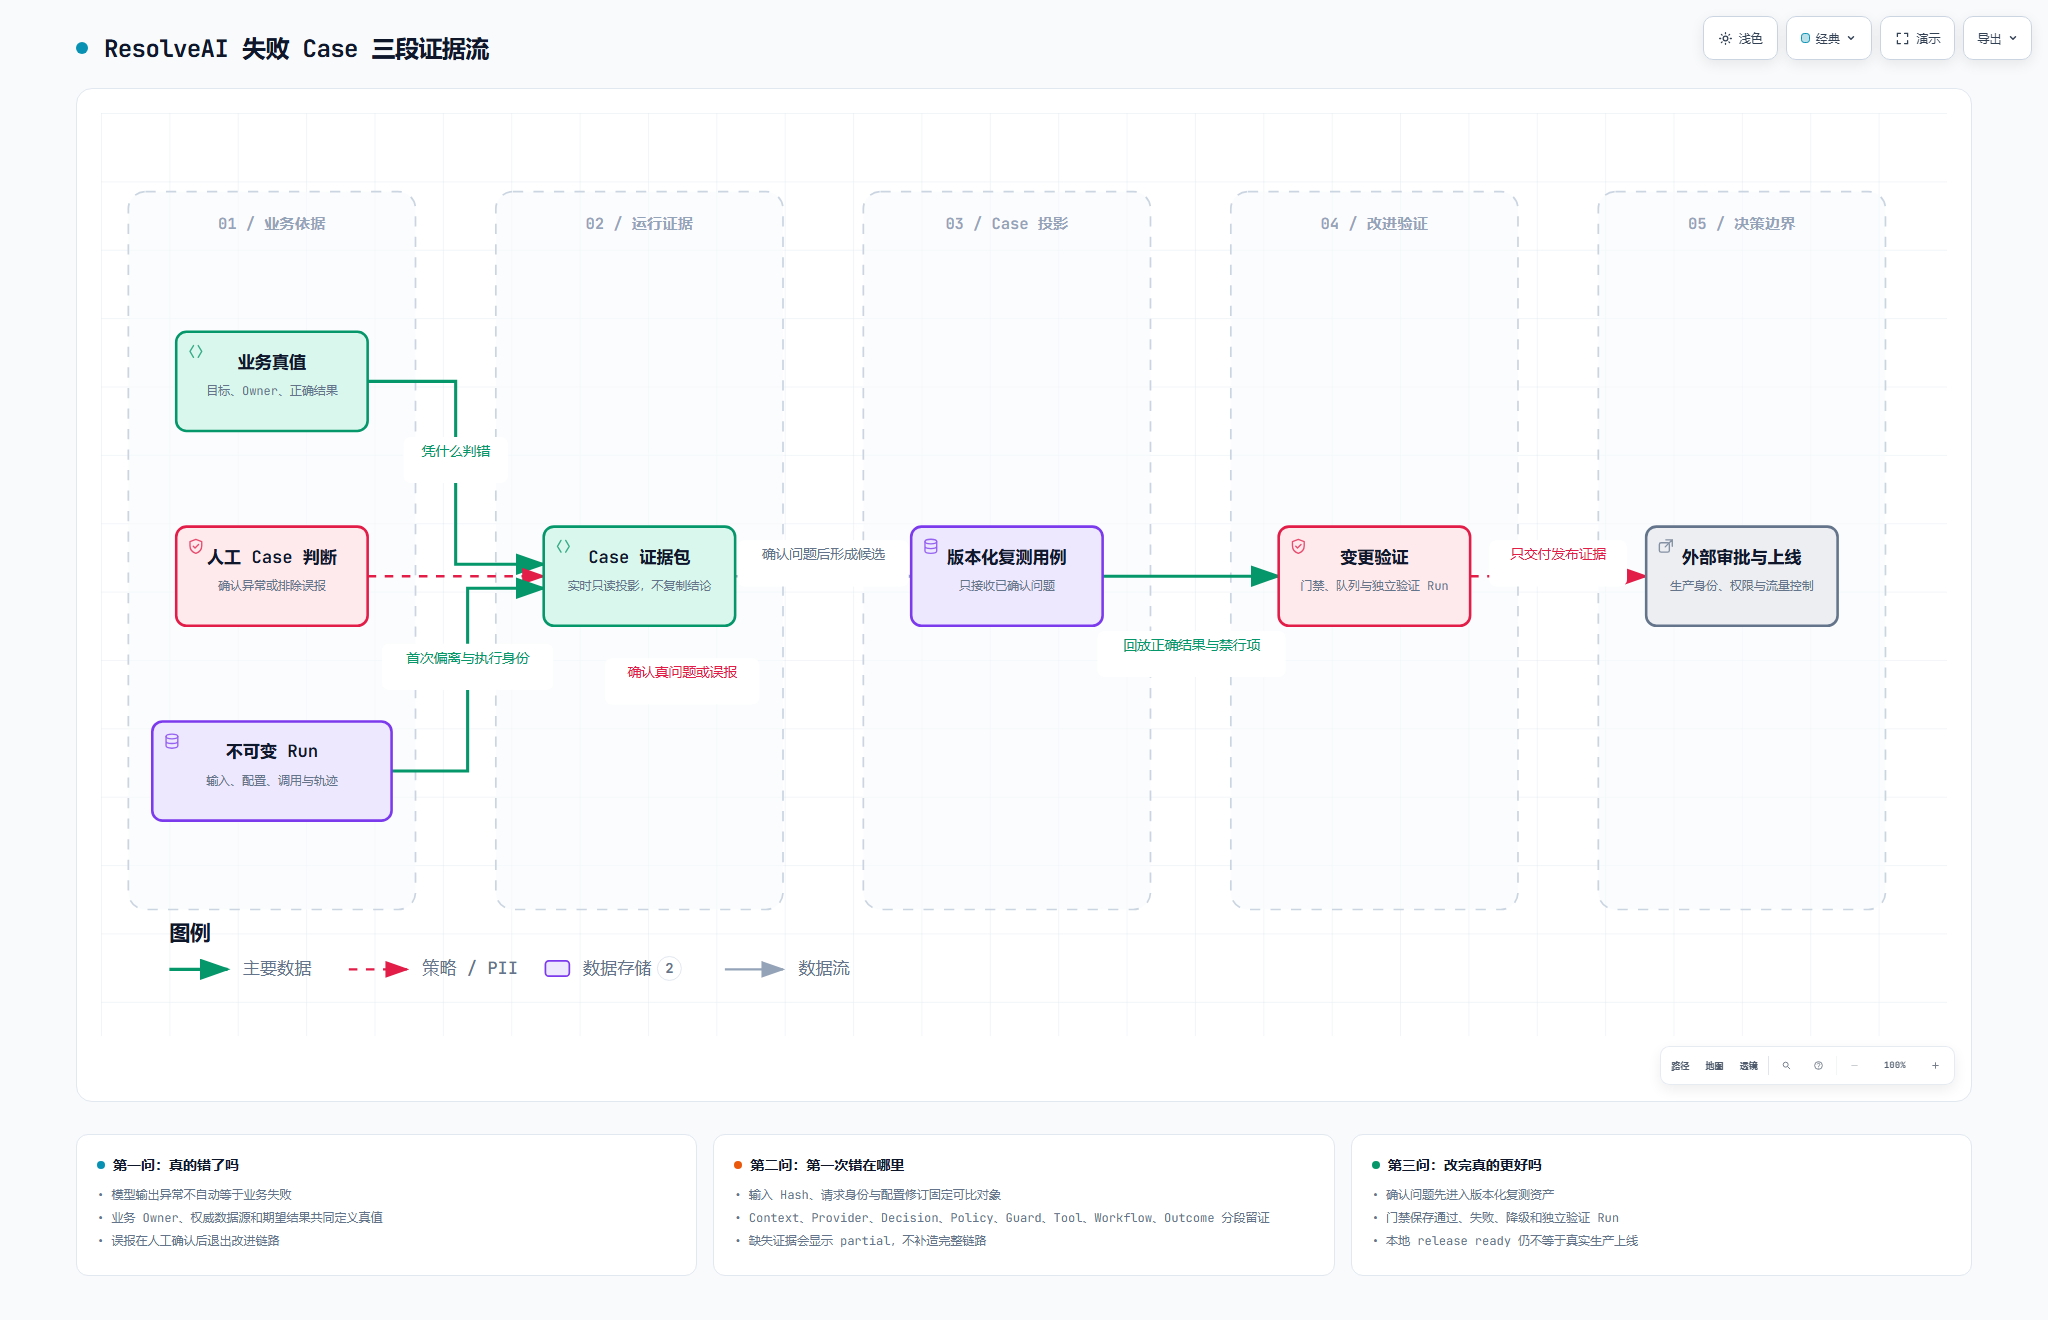
证据流:业务依据、人工判断和不可变 Run 汇入同一 Case 证据包;只有确认的问题才进入版本化复测和变更验证;生产审批与上线仍在本地项目边界之外。
为什么“模型答错了”仍然不是业务结论
模型输出不符合预期,可能有四种完全不同的情况:
- 业务目标确实没有达成;
- 评测规则过期或错误,运行其实是误报;
- 业务结果正确,但中间解释字段与理想答案不同;
- 真值本身不完整,当前无法判断。
因此第一段证据不从模型输出开始,而从受治理的业务场景开始。case-evidence-package-v1 读取客户目标、业务负责人、权威数据源、评测负责人和评测版本,并固定正确结果、必须动作、禁止动作与要求达到的业务状态。
这些字段回答的是“谁有权定义正确”和“正确具体是什么意思”。字段齐全只表示真值来源可追踪,不表示这个真值永远正确;人工仍可能签错,业务规则也可能变化。但没有这层,后面的根因分析只是围绕一个未经确认的答案展开。
Evaluator 的一个具体约束是:Evaluator 使用的业务真值不能由被评估模型在同一次运行中自我定义。
进入调查,不等于确认失败
以退款超时为例,业务已经超过正常时限,值得进入关注范围。但如果 Agent 正确查到已有异常单并继续跟进,业务风险与 Agent 处理错误就不是同一个判断。
这时先对照三个问题:当时应该做什么,实际做了什么,工具回执与业务结果是否支持结论。已有异常单不应重复创建,推进异常处理也不等于退款到账。
在个人版本的一条历史退款调查中,复盘结果为排除误报。它说明需要区分业务状态与处理质量;后续不沿这条记录生成修复结论。其他已确认问题的回归与发布记录,则按各自关联关系查看。
| 当前判断 | 后续处理 |
|---|---|
| 证据不足 | 补充事实或回执,保留待确认 |
| 处理符合要求 | 排除误报,必要时检查筛选依据 |
| 确认处理偏差 | 定位原因,形成后续复测输入 |
调查的出口不必全部通向修改。允许结束于“处理符合要求”,也是质量治理的一部分。
第一段:业务真值证据
业务真值部分记录四类内容。
第一类是目标和权威来源。例如一个退款 Case 的目标不是“回答流畅”,而是确认具体退款实体、读取正确状态,并在禁止重复建单时不产生副作用。
第二类是期望合同:outcomeCode、requiredState、requiredActions 和 forbiddenActions。它们把模糊的“应该答对”变成可执行的评测条件。
第三类是责任人:谁维护业务定义、谁负责评测、当前使用哪个版本。版本存在的意义是让历史 Run 保持历史真值,不因后来规则变化而被悄悄重写。
第四类是人工 Case 判断:pending_review、confirmed_issue 或 false_positive。系统可以自动发现异常并提出归因,但是否把它认定为真实坏例,必须留下人工判断。
这里最重要的反例是误报。如果人工确认业务结果符合规则,改进状态直接变成 not_applicable,不会继续形成复测候选。否则系统会把评测错误当成产品错误,越改越远。
第二段:运行归因证据
确认“真的错了”以后,才进入“第一次错在哪里”。
ResolveAI 不把所有失败都归到模型,而是逐段检查:
- Context:本轮需要的上下文是否完整、版本是否可识别;
- Provider:请求是否真实发出,是否限流、超时、截断或结构失败;
- Decision:模型抽取的事实和候选动作是什么;
- Policy:当前规则对正确动作和实际动作分别怎样求值;
- Guard:执行前门禁是否正确放行或阻断;
- Tool:业务系统调用是否发生,回执是否保存;
- Workflow:业务状态是否按版本化转换推进;
- Outcome:客户目标最终是否达成。
每一段不是简单红绿灯,而是 captured / missing / not_applicable。一次不需要 Tool 的回答,不应该因为“没有 Tool 回执”被判成证据缺失;一次本应执行 Tool 却没有回执,则必须显示 missing。只要适用证据没有全部采集,整个运行归因就是 partial。
为了让不同运行可比较,证据包还固定输入 Hash、Prompt 请求身份、模型、Provider Attempt 数量和配置修订。这样“修复后通过”才有资格回答:除了目标变化,别的关键条件是否保持一致。
AI 诊断只能解释证据,不能重写责任边界
Case 页面还包含 AI 只读诊断,但它位于不可变证据和人工复盘之间。
模型拿到的是服务端形成的证据 Packet,不是任意日志堆。它只能引用 Packet 中存在的 Check 和 Trace,返回候选根因或在证据不足时弃权。确定性责任信封已经把首次偏离落在哪一层固定下来,AI 可以解释“为什么可能在这里偏离”,不能把模型未遵循 Policy 改写成“Policy 配错了”。
更关键的是,AI 输出只会填充待核验草稿。它不能替人签署 confirmed_issue,也不能因为置信度高就把 Case 送入发布。
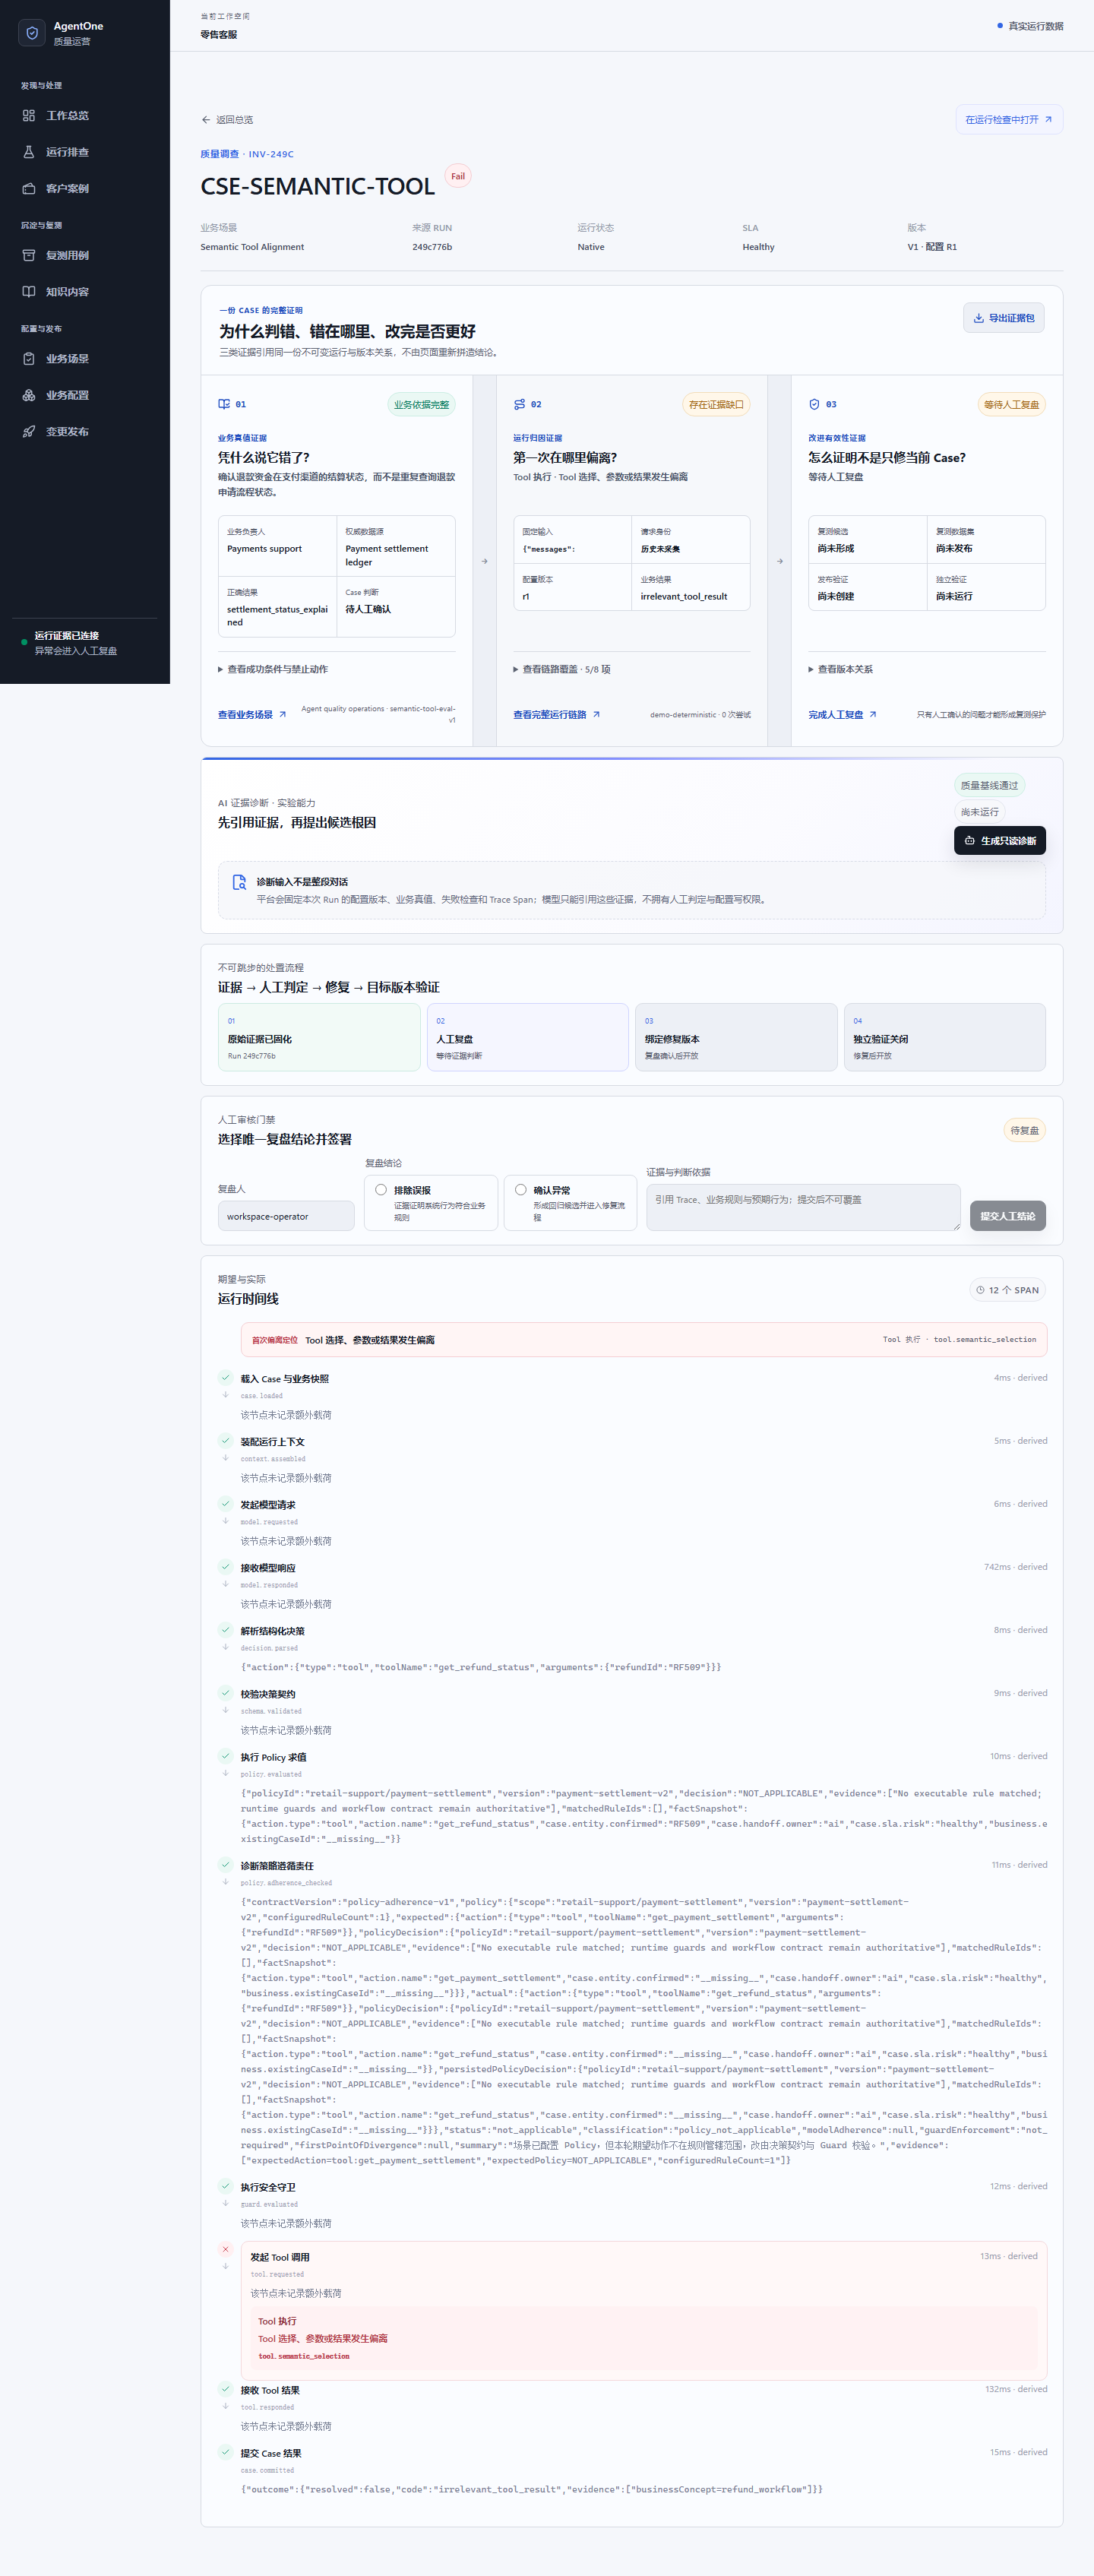
个人复现页面截图:顶部三列分别呈现判错依据、偏离环节与改进状态;下方保留 AI 诊断、人工复盘和运行时间线。
第三段:改进有效性证据
一个已确认问题不会直接变成“已修复”。它沿着以下状态前进:
- 等待人工复盘;
- 已形成复测候选,等待发布为版本化数据集;
- 已形成复测保护,等待创建变更验证;
- 正在运行发布验证;
- 验证仍有阻塞;
- 本地发布证据已就绪。
证据包会关联候选 ID、数据集版本与条目数、Release Candidate、目标配置修订、通过/失败/降级数量、泛化分类以及独立验证 Run。
这使“修好了”至少需要回答三个层次:
- 原始失败是否可稳定回放并被修复;
- 同模式变体、Held-out 和负向守卫是否没有退化;
- 结果绑定的是哪一个候选、数据集和配置修订。
ResolveAI 的“改进有效性证据”是把“防止复发”从一段行动项文字推进成可以回放的版本关系。但它仍然是本地离线证据,不等于企业已经批准上线。
ready_for_external_approval 到底是什么意思
这里需要特别澄清一个容易误读的状态。
当本地 Release Candidate 通过当前门禁后,证据包的下一步是 ready_for_external_approval。它表达的是:本地系统已经把可供外部决定的证据准备好。
具体审批角色、鉴权、灰度与上线流程,需要接入企业的组织和发布系统。这个状态用于标识交接位置,不预先指定某位审批人。
为什么证据包采用投影而不是复制
Case 证据包不是新建一份独立业务记录,再把 Run、场景和 Release 数据复制进去。它以 Investigation 为入口,实时关联现有对象并形成只读投影。
这样做有两个好处:
- 页面不能重新计算治理结论,从而避免前后端出现两套状态语义;
- 业务真值、运行证据和发布结果仍由各自权威对象维护,不会因为复制而漂移。
代价是查询依赖多个对象的一致性。在当前单进程 JSONL 实践环境中,这可以验证对象关系和恢复语义;大规模生产化仍需要数据库约束、事务边界、对象存储和跨存储一致性设计。
读者可能关心的边界问题
为什么不能直接以人工复盘结果作为完整 Case?
人工结论只能回答“我们当前怎样判断”,不能独立证明运行发生了什么,也不能证明修复有效。完整 Case 需要真值、执行证据和后续验证三者互相约束。
八段证据会不会太重?
不是每段都要求存在;not_applicable 是一等状态。重要的是先定义责任边界,再根据场景只采集适用证据,而不是把所有字段都塞满。
AI 诊断为什么不能直接写根因?
它可以生成候选根因,但必须引用证据并服从确定性责任信封。根因进入正式复盘需要人工核验,因为引用正确不等于因果结论正确。
谁做最终审批?
当前项目没有硬编码某一个人。它只把本地证据推进到“等待外部批准”的边界。真实企业接入后,应由具体业务 Owner、变更管理或安全流程定义角色和签名规则。
结语
失败 Case 的价值不在于保存了一次红色结果,而在于它能否成为一份可复核的改进合同。
先用业务真值证明“真的错了”,再用不可变运行定位“第一次错在哪里”,最后用版本化复测和独立验证回答“改完是否更好”。确认问题后,三段证据共同支撑后续改进;排除误报的调查则保留结论,不继续生成修复任务。