AF-E01 原本要回答一个很诱人的问题:TraceWise 和 TeachFlow 接入 Agent Foundation 后,治理效果到底有没有提升?
这次评估没有得到完整对照:g001 失败,g002 只有 partial,g003 到 g006 都没有产生正式样本,因此未计算综合分或提升百分比。
执行过程暴露了样本采集、测量和环境隔离问题。下面按各个 generation 说明它们在哪里中断、原因是什么,以及恢复评估前需要补齐哪些条件。
先澄清标题:这里的“六个 generation”不是六次完整 A/B 实验。它们是六次冻结计划或准备代次,其中只有 g002 留下 33 条正式 raw events;其余在更早的门被 fail closed。
查看 Agent Foundation 项目总览 · 打开本文交互图
我真正想测量什么
AF-E01 没有把模型答案质量纳入评估。它关注的是三类治理行为:
- Foundation 是否能阻止陈旧或越权语义继续被使用;
- 个性化 authority 不可用时,产品是否仍能保留客观结果,而不是伪造“没有记忆”;
- 重放、响应丢失和恢复是否会产生重复的 authority write。
延迟、调用数、写入数和人工步骤可以报告,但只是当前环境下的局部观测。它们不是生产 SLA,更不能推导模型更聪明、学生学得更好或分析结论更准确。
先冻结合同,再允许样本出现
正式 run plan 会冻结:
- adopter commit 与 package identity;
- scenario、arm 与 invocation identity;
- 21 个 metrics;
- 每个 metric 的
hard、counterfactual_observation、report_only或带理由的not_applicable; - fault point;
- denominator 与样本数量;
- gate inheritance;
- storage budget 与资源前置条件。
后续候选合同包含 33 个 scenarios、95 个 independent invocations 和 693 个 gate assignments。重要的不是数字大,而是它们在执行前被冻结,避免看到结果以后再修改门槛。
paired comparison 只用于可以公平构造相同输入、相同业务状态和相同 fault point 的场景。无法构造公平对照的项目,只能做 single-path conformance。二者不能混在同一个“提升”分母里。
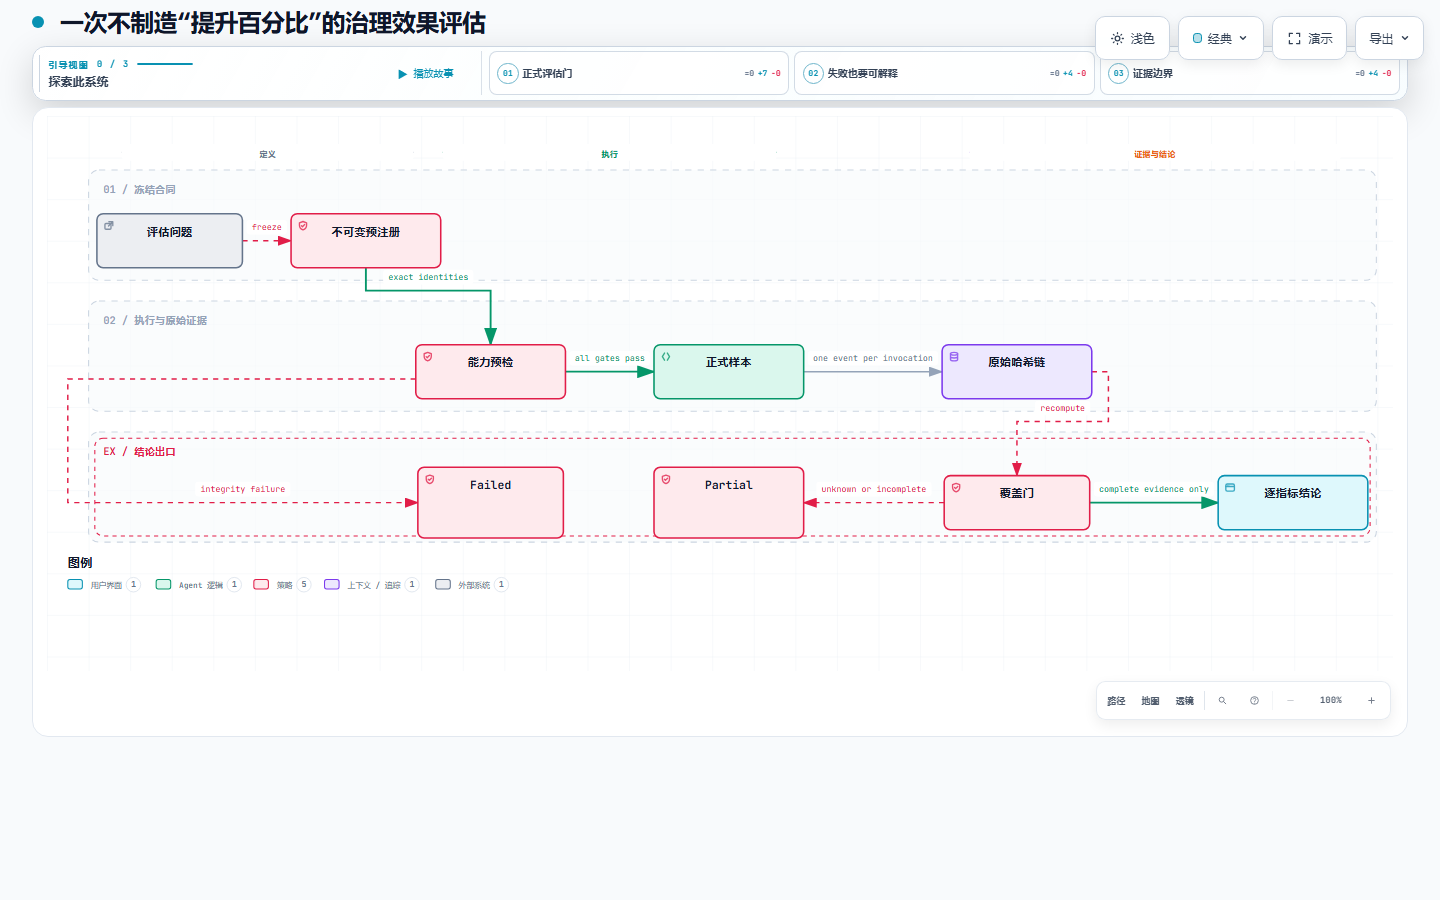
技术解释图:完整样本才进入逐指标报告;source integrity failure 与 paired evidence 缺失分别进入 Failed 和 Partial,而不是被综合分吸收。
g001:测试还没开始,source stage 已经不再不可变
g001 的 source stage 来自冻结源码,但正式测试进程在其中写入了 cache、bytecode 和 runtime database。结果是:评估前后 source fingerprint 不一致。
业务用例可能仍能运行,但因果边界已经失效。无法判断结果变化来自产品、Foundation,还是测试过程对源码目录的污染。
Harness 因此在 source integrity gate 直接终止:
- formal metric count:0;
- scorecard:不存在;
- 状态:failed。
这个失败推动了执行目录隔离和环境生命周期修复,但没有被回写成“g001 后来通过”。历史结果保持失败。
g002:33 条事件都合法,结论仍然只能是 partial
g002 产生了 33 条 formal raw events,hash chain 完整,也没有 hard gate failure。然而关键 paired observations 不完整:
- TeachFlow:16 个 events,38 个 unknown assignments;
- TraceWise:14 个 events,49 个 unknown assignments;
- Foundation reference:3 个 events,0 unknown,但样本不足以替代 adopter 对照。
如果把 unknown 当成 pass,就可以生成一个很漂亮的分数。Harness 选择了相反的规则:unknown 不是 pass。
因此:
- aggregate score:
null; - improvement percentage:
null; - 状态:partial。
33 条 raw events 仍然有价值。它们说明部分单路径治理行为可执行,也暴露了 authority observation 不足。但它们不能支撑跨 adopter 的总体效果结论。
g003–g006:为什么“没有正式样本”也是结果
后续 generation 先后发现了正式输入、时钟、构建可复现性、zero-write 测量、controller 依赖和资源生命周期等问题。每次都在 formal sample gate 之前停止。
其中一个典型反例来自 TF09。最初 Harness 用完整 pg_dump --data-only --inserts 文件 hash 判断越权请求是否写库。即使完全不发送请求,连续三次 dump 的文件 hash 仍然变化。
根因不是 TeachFlow 写入,而是 PostgreSQL 每次生成新的 \restrict / \unrestrict token。whole-file hash 把工具控制 token 误判成语义数据变化。
修复后,TF09 使用一致性事务中的 canonical per-table/per-row fingerprint,并把数据分为 semantic、authority、operational 和 sequence 四类。真实诊断证明:
- 两次独立跨班级请求均返回 403;
- semantic row changes:0;
- authority row changes:0;
- operational row changes:0;
- modification SQL log 中 INSERT/UPDATE/DELETE/DDL:0。
这个修复恢复了测量工具的可信度,但没有把 g005 升级成通过结果;g005 在冻结时仍然没有 formal samples。
同理,g006 在正式 TF09 请求前发现 evaluation controller 缺少 psycopg,于是停止。依赖后来被补进 capability preflight,也不能冒充 g006 当时已经执行了 PostgreSQL snapshot。
评估环境为什么一度膨胀到十几 GiB
早期 retention 规则把每个失败 generation 的 venv、node_modules、source export、container 和 database volume 都当成需要永久保留的“证据”。多次失败后,AF-E01 retained storage 超过 11 GiB,甚至触发 12 GiB hard stop。
这暴露了另一个错误假设:可重建环境不等于不可替代证据。
最终我把 generation 生命周期冻结为三种状态:
active:最多只能有一个完整运行环境;forensic_hold:必须有 owner、expiry、明确原因和 bounded bytes;compact_evidence_only:失败或结束后的默认状态。
关闭 generation 的固定顺序是:
- 写出紧凑证据包;
- 验证 package、run plan、result、hash chain、关键错误和重建身份;
- 封口 host process、port 与 log;
- 封口 Docker container;
- 生成 exact retention manifest;
- 只处理 manifest 明确列出的可重建目标。
完成一次精确清理后:
- retained storage 从
12,224,597,564 bytes降至1,804,953,481 bytes; - 释放
10,419,644,083 bytes; - AF-E01 container 数为 0;
- 保留 17 个 volumes;
- g002 的 raw events、hash chain 和 scorecard 保持;
- g001–g006 的 plan、freeze/result、summary 与关键错误保持。
这些数字描述的是 evaluation 基础设施治理,不是产品性能提升。
这次 partial 评估到底产出了什么
它没有回答“Foundation 提升了多少”。它产出了四类更基础的资产:
1. 一个不会事后改分母的 Harness
合同、样本身份、gate mode 和 package identity 在执行前冻结;missing 和 unknown 不会在汇总阶段被悄悄消失。
2. 一组可复用的测量反例
包括 source-stage 污染、pg_dump 非业务 token、controller 依赖缺失、宿主机子进程未封口和 retention 膨胀。这些都曾经足以制造错误结论。
3. 明确区分 hard、counterfactual 与 report-only
治理安全门失败会阻止结论;反事实观测不会伪装成真实对照;延迟与资源成本可以报告,但不决定语义安全是否通过。
4. 一条紧凑证据生命周期
失败环境不再永久占用磁盘。保留的是能复核结论与重建环境的证据,而不是每一份可重新安装的依赖树。
下一次评估要满足什么
如果未来恢复正式 generation,至少需要:
- 两个 adopter 都绑定 immutable formal inputs;
- controller capability preflight 在任何产品资源创建前通过;
- source、wheel 与依赖可复现;
- authority observation 在正确边界可见;
- semantic zero-write 使用 canonical database fingerprint;
- 只有一个 active environment;
- 预算允许完整执行并在结束后进入 compact evidence lifecycle;
- paired denominator 完整,否则继续报告 partial。
当前仍缺完整的跨 adopter 配对观测。测量工具的修正需要用于下一次评估,才能重新回答最初的效果问题。
边界
本次范围是本地治理机制与测量流程。模型答案质量、教学效果、产品准确率和生产 SLA 未纳入评估,retention 清理记录的是存储变化。
恢复正式执行前,先检查完整输入、测量可见性和环境预算。配对观测齐备后再计算逐指标结果;缺失项继续保留为 unknown。