我在设计 Agent Foundation 时反复遇到一个看似简单、实际很容易说混的问题:Agent 的记忆究竟应该有多自治?
如果系统只能被动保存用户手工指定的内容,它很难形成长期价值;如果模型可以自己抽取、合并、改写甚至删除记忆,它又可能把一次推断直接升级成产品事实。两种极端都不理想。
为了把问题说清楚,我重新固定审查了两个开源参考项目:
- MemoryBear,固定到
main@6f469908ce8222d6abdc569e6fb3b2b3e97af37a; - MindMemOS,固定到
main@186db4a75122b1d8691933f280bec10191c82c28。
这次调研基于源码与机制分析,没有进行统一数据集上的运行对比。核心问题是:哪些自治机制进入了 Agent Foundation,解决了什么问题,它们在产品中拥有怎样的权限?
这里的“内化”不是把参考项目换个名字,也不是只写一层校验。Foundation 已经实现了 bounded implicit Dreaming、混合召回与激活生命周期、可恢复的容量压缩、实体消歧与规范化、受限 Graph formation、反馈重排、Schema 双路径检索与受限演进等机制。它们保留了参考项目解决问题的核心,但使用 Foundation 自己的 Registration、Evidence、Policy、ReviewDecision 和 receipt 语义重新落地。
查看 Agent Foundation 项目总览 · 打开本文交互图
先拆开“自治”这个词
“系统会自动记忆”至少包含四种不同能力:
- 候选发现:从对话、文档、工具结果或任务反馈中发现值得保留的内容。
- 结构形成:把原始内容转成摘要、实体、关系、episode、vector 或 skill candidate。
- 自治维护:根据访问、时间、反馈和相似度做去重、合并、归档、强化或重组。
- 权威写入:让上述结果成为产品此后可以依赖的当前事实,并影响用户可见结果或后续动作。
前三项主要回答“怎样让记忆更有用”,第四项回答“谁有权让它生效”。我后来发现,很多争论不是在讨论同一件事:有人说的自治是自动摘要,有人说的自治却已经包含改写业务事实。
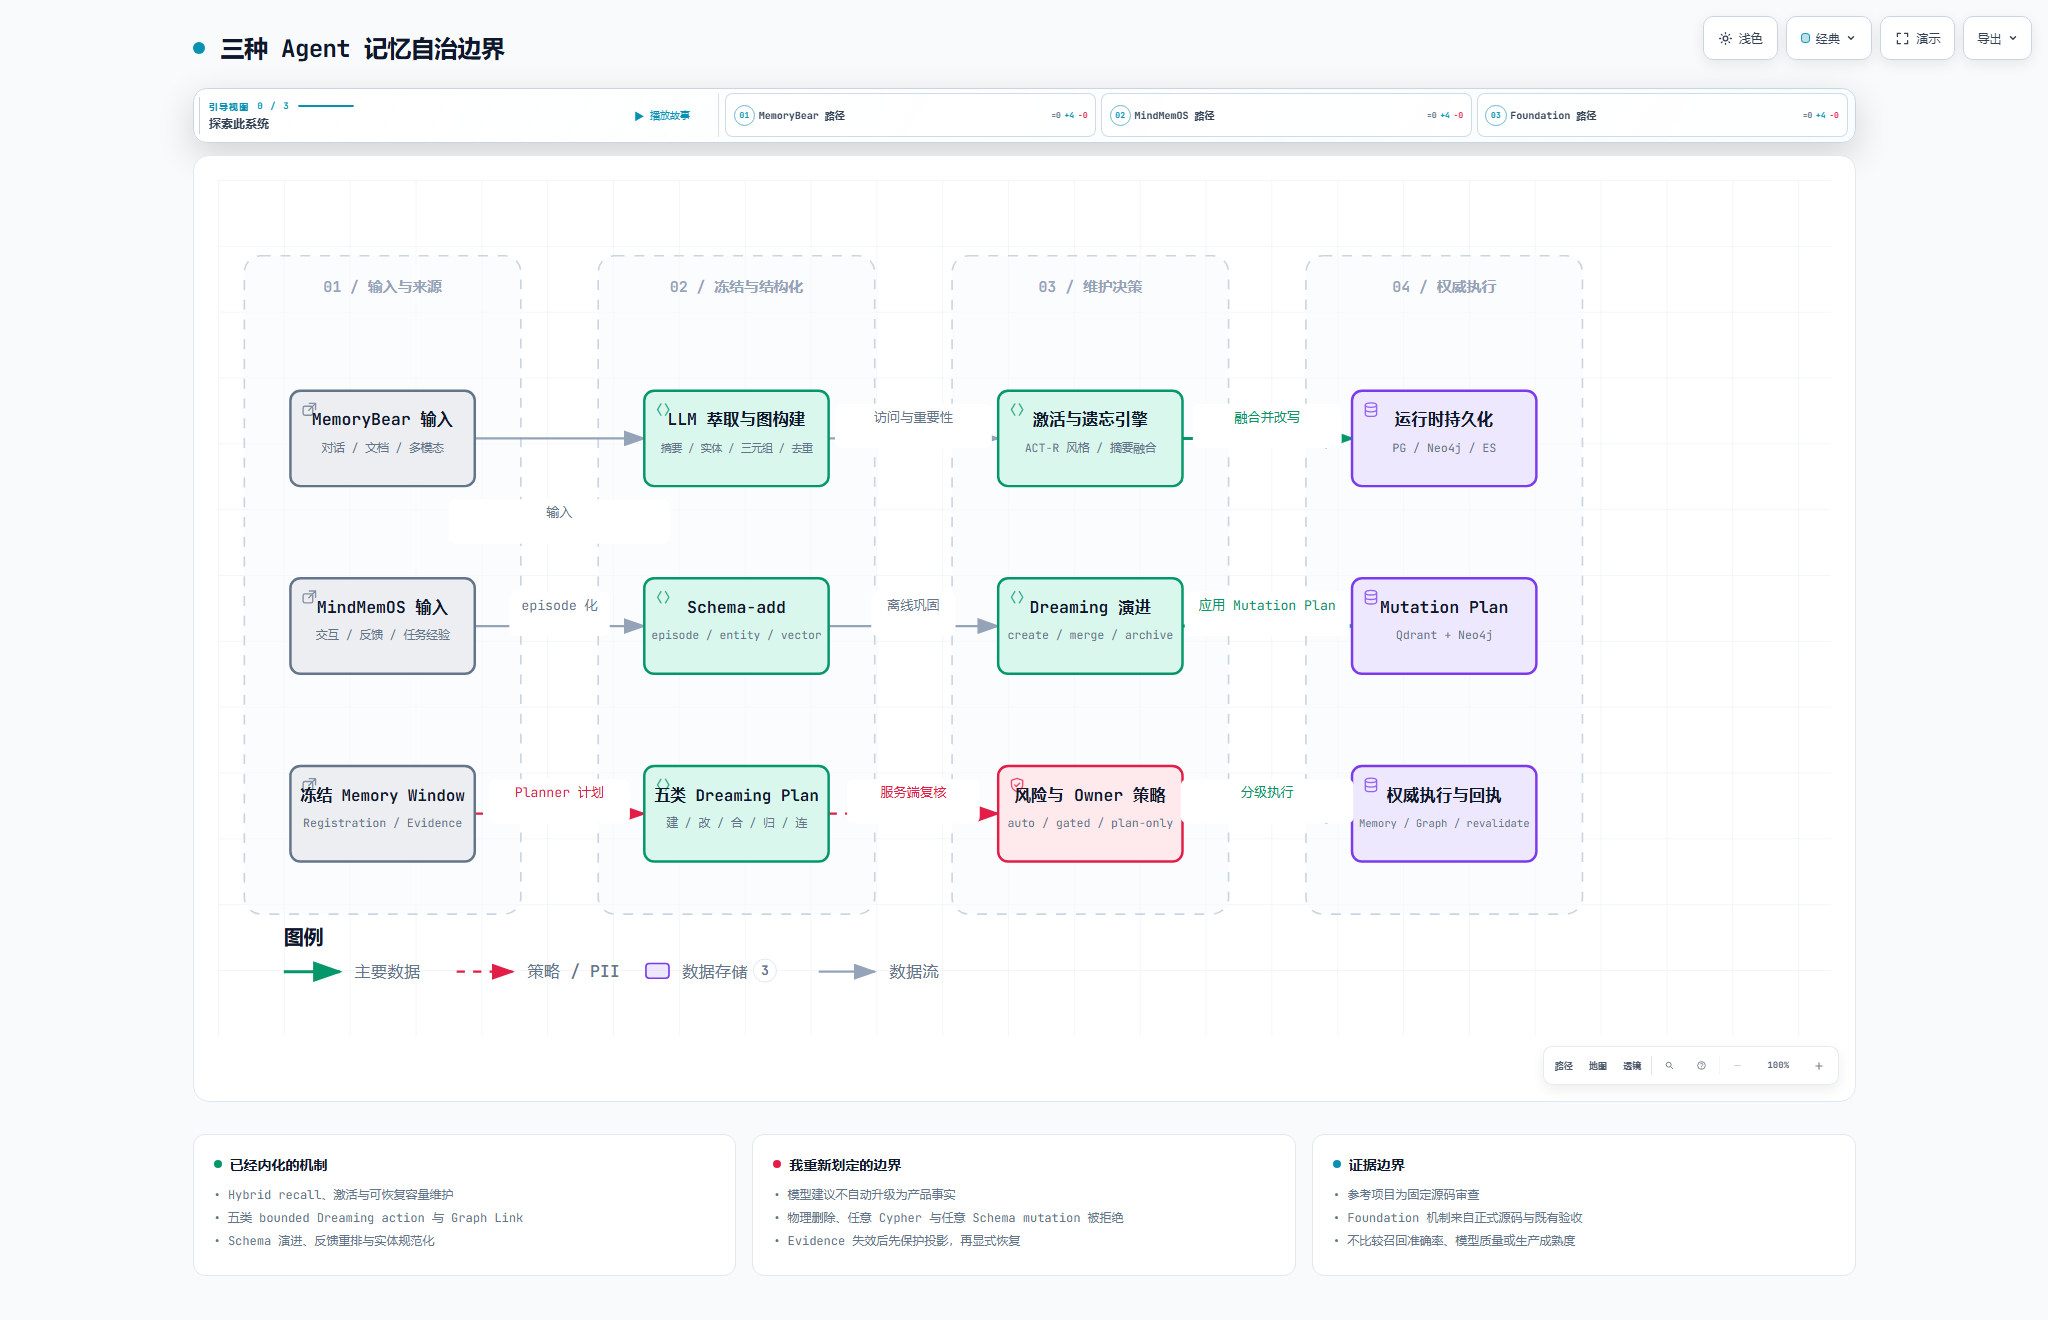
技术解释图:三条路径都允许系统主动发现和组织记忆;差异集中在持久化权威如何形成。图中参考项目部分来自固定源码审查,不代表端到端运行验证。
MemoryBear:把“遗忘”做成长期维护,而不是简单删除
MemoryBear 给我的第一点启发,是不要把长期记忆理解成“把聊天记录放进向量库”。它的写入流水线会编排抽取、图节点与边构建、去重消歧、摘要和多模态处理,再把结果落到 Neo4j 等存储中。换句话说,它首先把记忆当作一个需要持续加工的结构,而不是原文的备份。
更值得研究的是遗忘机制。固定源码中的 forgetting engine 使用 ACT-R 风格的激活计算、访问历史与阈值筛选低激活节点;另一条策略会创建 MemorySummary,继承较高的激活值和重要性,保留原 Statement / Entity 标识,再迁移关系并处理原节点。
这里最有价值的不是“模拟人脑”这个表述,而是一个工程判断:
遗忘不一定等于立刻丢失;它可以是把低价值细节压缩成仍可追溯的概括。
这比按时间删除旧记录可靠得多。访问频率、重要性、相互关系和来源都可以进入维护决策,系统也能把存储预算用在更有价值的内容上。
但源码同样说明了它的边界:这些动作属于记忆运行时自己的 mutation pipeline。对一个以个人长期记忆为中心的系统,这可能是合理选择;对一个会影响教学评价、Graph 业务状态或人工审核结果的产品,仅有“模型认为应该合并”还不足以成为最终授权。
MindMemOS:自治不仅整理记忆,还会演进结构
MindMemOS 当前 main 已经不能再用“只有静态 schema”来描述。固定源码里存在完整的 schema-add pipeline:它会缓冲记录、切分 episode、通过 worker/drain 处理失败与重试,并形成 schema entity、vector 和 graph 写入计划。
它的 Dreaming pipeline 更进一步。系统可以聚类热点记忆,处理精确重复,调用关系检测和 action planning,再把 create、merge、archive、link 等动作组织成 mutation plan。Skill 也有从使用结果、失败轨迹和反馈中继续演进的路径。
这个设计揭示了第二个重要事实:
当记忆规模变大时,仅靠“写入时一次性抽取”不够;系统需要离线巩固、结构学习和持续维护。
它也给出了一个很现实的多存储边界。memory_db/writer.py 会协调 Qdrant 与 Neo4j;fast 模式并行写入,strong 模式按顺序执行,并通过 graph_pending 和 errors 表达未完全收敛。源码没有提供 PostgreSQL/Neo4j 式跨存储 ACID 的证明,我也不应把 strong 这个名字解释成分布式事务。
在所审查的默认 Dreaming 路径中,mutation plan 由运行时应用;该路径未提供与 Agent Foundation 对应的独立 proposal、业务 reviewer 和 executor 公共门禁。两者的权限划分不同:前者侧重记忆运行时的演进,后者将产品写入拆为提案、审核与执行。
不是只借鉴:我们已经实现了什么
回看这些工作,我认为最重要的不是功能数量,而是每一项实现都对应一个长期记忆系统会真实遇到的失效模式。
| 参考机制 | Foundation 已实现的版本 | 为什么实现 | 重新划定的边界 |
|---|---|---|---|
| MemoryBear 的多信号召回与激活思路 | 固定配置的 hybrid / corroboration-aware recall,把 lexical、dense、recency、访问和独立来源信号纳入有界排序 | 单一向量相似度无法稳定表达“相关、当前、可信、常用” | 权重与容量由 Registration / policy 固定;不把一次点击直接解释为事实正确 |
| MemoryBear 的遗忘、摘要融合与容量维护 | ACT-R-inspired activation、容量触发的 source-preserving compaction、可恢复 dormancy / restore | 长期记忆不能只增不减,但删除原始来源会破坏审计和恢复 | 生成有 lineage 的 successor;来源保留为可恢复状态,不做物理删除 |
| MemoryBear 的实体发现、别名合并与 Graph formation | bounded entity-resolution、entity canonicalization、allowlisted relation formation 和有界关系召回 | 别名和重复实体会把同一人的记忆切碎,关系若完全不形成又无法支持结构化召回 | 先形成 typed plan;只允许同 Scope、Evidence-bound 的有限形状,不开放任意 Cypher,也不 DETACH DELETE |
| MindMemOS 的 Dreaming mutation plan | mindmemos-bounded-implicit-dreaming-v1:冻结 2–8 条活跃 Memory,支持 create、update、merge、archive、link 五类动作 | 写入时一次抽取无法长期解决重复、过期、冲突和新关系,系统需要后台巩固 | 三种模式:低风险自动、policy-gated、proposal-only;高风险动作需 owner decision,过期 window 零写入 |
| MindMemOS 的 Dreaming Graph Link | 同 Scope、allowlist、source-bound 的 additive Memory / Entity link | 记忆巩固可能发现新的可解释关系,不能永远只停留在文本层 | Graph mutation 仍由权威端执行;禁止任意 endpoint、关系类型和跨 Scope link |
| MindMemOS 的 Schema 检索与演进 | Entity / property-bound 双路径检索,以及 additive optional-property Schema candidate → validate → publish → Registration replacement | 固定 Schema 会阻塞新领域,但运行时随意改 Schema 会破坏已有项目合同 | 只接受受限的可选属性扩展;rename、delete、type narrowing 和自动激活均被拒绝 |
| MindMemOS 的反馈驱动维护 | exact receipt-bound owner feedback、append-only event、signed-clamp reranking、archive / restore | “有用 / 没用”反馈应影响后续召回,但不能变成无来源的隐式改写 | 反馈必须绑定实际 Runtime receipt 和 Memory revision;分数贡献可解释,归档可恢复 |
| MindMemEvolve 一类离线策略搜索 | immutable Schema candidate envelope 与独立验证门 | 允许离线实验生成更优候选,同时避免实验结果直接污染在线权威 | candidate 默认零激活;只有独立验收和显式发布后才能进入 Registration |
这张表也解释了为什么我们此前花了很大力气:目标从来不是“再做一个 Memory SDK”,而是让自治维护真正可用,同时避免它把模型判断、用户反馈、来源变化和产品写权限揉成一个不可审计的动作。
Dreaming 已经是 Foundation 的正式机制
这一点尤其需要澄清。Foundation 不是只从 MindMemOS 得到“以后可以做 Dreaming”的启发,而是已经实现了一条 Registration-bound 的 bounded implicit Dreaming 路径。
执行前,系统冻结当前活跃 Memory window、source revision、Evidence lineage、Planner identity、policy fingerprint 和动作预算;Planner 只能在这个窗口上输出最多八个 typed actions。服务端随后重新验证作用域、版本、来源保留和风险等级,再决定动作属于自动执行、owner decision 还是仅保留 proposal。执行过程逐项产生 receipt;Graph 暂不可用时以 graph_pending 暴露未收敛状态,而不是把部分成功伪装成完整成功。
这不是复制 MindMemOS 的完整运行拓扑。Foundation 没有把上游的调度器、Kafka、Qdrant、Neo4j 组合或模型 Planner 一并收入平台;它内化的是 Dreaming 的维护语义,并把触发、计划、授权、执行和恢复拆成可替换的职责。
MemoryBear 的策略也不只是写进了调研文档
MemoryBear 相关工作同样已经越过“想法”阶段:混合召回、可逆 dormancy、capacity compaction、entity-resolution、canonicalization、Graph formation 与 bounded relation recall 都有对应的 Foundation 合同或服务实现。
Foundation 采用了其中三个约束:访问与时效影响排序;容量维护保留来源;实体合并可追踪、可阻止、可恢复。它们分别用于处理陈旧召回、无限增长和身份碎片化;上游删除策略和完整认知模型不在这次采用范围内。
所有内化机制共享同一条权威底座
普通开发者不应该为每种输入手写一套存储协议。Foundation 允许 Agent 把当前 turn 的 typed Observation、精确 Evidence binding 和候选内容交给统一路由;但文本相同不代表来源、可见性和发布权威相同,因此每个真正生效的结果仍绑定 Evidence revision、subject、Registration、policy 和 target generation。
Evidence 失效时,系统先关闭不安全投影;replacement Evidence 到来后,再通过显式 revalidation 恢复。Dreaming、压缩、实体规范化和反馈重排都不能越过这条底座。历史不会因为模型重新整理了一次内容而被静默改写。
我重新划定了什么
真正的分歧发生在第四层:谁可以让候选成为产品事实。
Agent Foundation 把这条路径拆成了几件独立的事:
- Agent 产生 typed Observation 或零写入 Proposal;
- Evidence Authority 确认来源、revision 与 lineage;
- Policy 判断候选是否具备 auto-apply 或必须 review 的资格;
- ReviewDecision 记录实际 actor、represented owner、理由与冻结 action;
- 独立 executor 消费 durable outbox,写入目标权威并产生 receipt;
- Evidence 后续失效时,dependency fence 与 revalidator 关闭或恢复安全投影。
这种设计牺牲了一部分“模型一次调用就自动完成所有事情”的流畅感,但换来了可审计、可撤销、可恢复的边界。尤其在 Graph 变更中,submitter、reviewer 和 executor 不应共享一个模糊的超级凭据。
哪些部分我们刻意没有照搬
| 上游能力或做法 | Foundation 的处理 | 原因 |
|---|---|---|
| 完整上游存储与调度拓扑 | 不复制 | Foundation 提供治理与权威能力,不接管 adopter 的模型、调度器和全部基础设施 |
| 模型自由执行任意 Memory / Graph CRUD | 拆成 typed plan、policy、review 与 authority execution | 模型擅长提出结构候选,但不应天然拥有产品写权限 |
| 物理删除、破坏性 entity merge | 拒绝作为维护默认 | 它会同时损失来源、审计和恢复能力;当前采用 archive、redirect、successor 和可恢复 dormancy |
| 任意 Schema mutation | 只保留 additive optional-property 演进 | rename、delete、type narrowing 会让既有 Registration 与数据解释失效 |
| 把完整 MindMemEvolve 优化器放进在线 Runtime | 保留离线 candidate envelope,不自动激活 | 评估循环和产品在线权威应分离,避免实验结果直接成为运行配置 |
| 把 Skill evolution 并入 Memory Core | 保持为独立能力边界 | Skill 的执行风险、评估方法和发布责任不同于用户 Memory |
| 依靠内容相同推断来源相同 | 明确拒绝 | 内容 fingerprint 不能证明 subject、Scope、可见性或发布权威 |
为什么不是“所有写入都要人工审批”
把治理理解成“每条记忆都弹出审批框”同样是错误的。Foundation 的 personal-safe 路径允许完整、精确、owner-explicit、低风险的当前偏好在封闭本地环境中审计式 auto-apply;不确定计划、事实冲突、敏感内容和生产环境候选则进入 review。
也就是说,系统不是用人工审核替代自动化,而是按影响面分配自治:
- 低风险、可逆、来源明确:可以自动执行并留 receipt;
- 高影响或来源不确定:必须等待 owner/reviewer;
- 证据已失效或权威无法确认:fail closed,不伪装成普通空结果;
- 只是上下文、不会改变资格:允许 typed degraded,不阻塞主流程。
这比“自治 / 不自治”的二元开关更接近真实产品。
这次调研也纠正了我自己的旧判断
早期研究快照里,我曾把 MindMemOS 的 schema 学习看作主要停留在公开描述、尚缺完整持久化路径。当前固定源码已经出现 schema-add worker、drain、mutation plan 与 Dreaming apply,这个旧结论不再成立。
这也是为什么技术调研必须固定 commit,并把“当时的观察”与“当前事实”分开。否则,博客很容易把已经被上游实现改变的判断永久写成标签。
两个项目 README 中的性能数字来自各自的测试环境。硬件、数据与配置未统一,因此本次比较只讨论机制,不比较性能百分比。
最后的判断
我现在会把“记忆自治”定义成一句更具体的话:
Agent 可以主动发现、组织和维护候选;但自治的上限,应由结果是否可撤销、可审计、可恢复,以及它将影响谁来决定。
MemoryBear 让我看到长期记忆必须会衰减、融合和保留 provenance;MindMemOS 让我看到 schema、Dreaming 和反馈可以持续改变记忆结构;Agent Foundation 则已经把其中可复用的部分实现为受限能力,并放进统一的产品权威模型里。
这三者不是同一道题的三个分数。它们分别强调记忆结构、自治演进和产品治理。真正有价值的参考,不是复制最多的功能,而是看清每个机制解决了什么问题,再决定它在自己的系统里最多可以拥有多大的权力。
证据边界
- MemoryBear 与 MindMemOS 结论来自上述固定 commit 的源码审查,证据等级为
code-confirmed;本文没有启动其完整服务、数据库和模型链路。 - Agent Foundation 的 bounded Dreaming、MemoryBear-derived lifecycle / entity / Graph 机制,以及 proposal、review、executor、receipt 与 Evidence dependency 能力,依据正式源码与既有本地 installed-package / PostgreSQL / Neo4j 验收。各机制的执行覆盖不同,尚无统一的产品效果对照。
- 召回准确率、成本、延迟和模型质量需要另行设计统一测试。
- Agent Foundation 当前仍是 bounded developer preview,不是 production-ready 或公开发布的软件。